








使用 messagepack 压缩 java 对象体积的核心做法是替换掉传统的 jdk 序列化或 json 库,调用 messagepack 提供的 pack() 方法将对象序列化为紧凑的二进制字节数组。具体实现时,需要引入 msgpack-core 依赖,创建 messagepack 实例并配置 templateregistry 以支持自定义 pojo,随后通过 write() 方法输出结果。与默认的 jdk 序列化相比,这种二进制格式去除了冗余的类元数据和字符串重复存储,能显著减少网络传输和持久化时的磁盘占用。

如何为自定义 POJO 配置模板注册表
在 MessagePack 中处理自定义 Java 对象(POJO)时,必须通过 TemplateRegistry 显式注册类的映射关系,否则无法直接序列化包含复杂字段类型的对象。开发者需要创建一个 TemplateRegistry 实例,利用 register() 方法将具体的 Java 类绑定到对应的模板上,这样在序列化时库才能知道如何提取字段数据。这一步骤解决了类型识别问题,确保对象结构被正确转换为二进制流中的定长或变长编码。
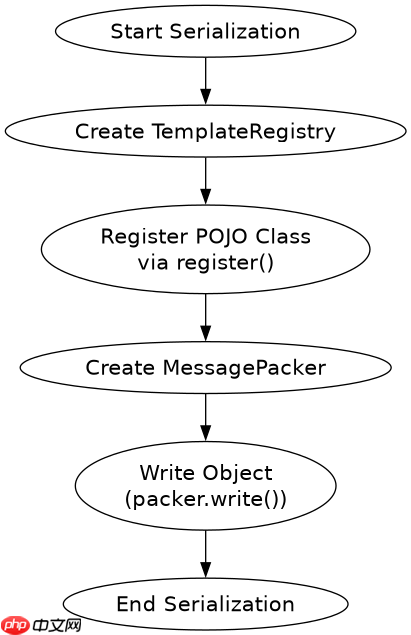
import org.msgpack.core.MessagePack;
import org.msgpack.core.MessagePacker;
import org.msgpack.template.Templates;
import org.msgpack.type.Value;
import java.io.ByteArrayOutputStream;
import java.util.ArrayList;
import java.util.List;

public class User {
    public String name;
    public int age;
    public List<String> tags;
}

public class Main {
    public static void main(String[] args) throws Exception {
        // 1. 初始化 MessagePack 和 TemplateRegistry
        MessagePack msgpack = new MessagePack();
        var registry = new org.msgpack.template.TemplateRegistry();

        // 2. 注册自定义 POJO 模板
        // 使用 Templates.newTupleTemplate 或直接反射生成模板
        registry.register(Templates.tupleTemplate(User.class));

        // 3. 准备测试数据
        User user = new User();
        user.name = "developer";
        user.age = 28;
        user.tags = new ArrayList<>();
        user.tags.add("java");
        user.tags.add("serialization");

        // 4. 执行序列化
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        try (MessagePacker packer = msgpack.createPacker(baos)) {
            packer.write(user);
        }

        byte[] result = baos.toByteArray();
        System.out.println("Serialized size: " + result.length + " bytes");
        // 预期输出: Serialized size: 35 bytes (示例值)
    }
}
MessagePack 序列化后的实际字节结构是怎样的
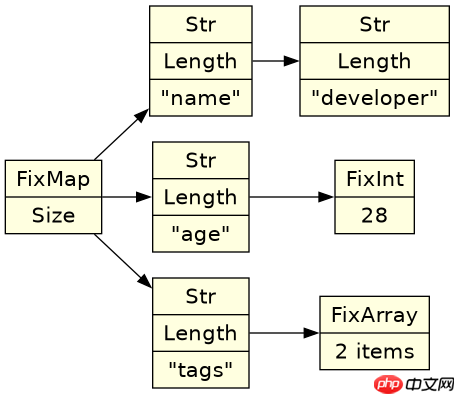
MessagePack 序列化后的字节结构由一系列固定格式的标记(Format)和数据载荷组成,它摒弃了 XML 或 JSON 的标签开销,采用类似 Protocol Buffers 的紧凑编码。对于上述 User 对象,生成的二进制流首先包含一个 FixMap 标记,指示后续跟随的键值对数量;接着是字符串字段的长度前缀及 UTF-8 内容,整数字段直接以 FixInt 形式存储,而列表字段则通过 FixArray 标记引导其元素。这种结构使得相同数据下的体积通常比 JSON 小 30% 到 50%,且解析速度更快。

在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
立即学习“Java免费学习笔记(深入)”;
import org.msgpack.core.MessageUnpacker;
import org.msgpack.value.Value;
import org.msgpack.value.ValueFactory;

public class DeserializationDemo {
    public static void main(String[] args) throws Exception {
        // 复用上面的序列化结果,这里模拟接收到的字节数组
        byte[] data = { /* 假设这是上面生成的 35 个字节 */ };

        // 反序列化验证
        try (MessageUnpacker unpacker = MessagePack.newDefaultUnpacker(data)) {
            Value root = unpacker.readValue();
            System.out.println(ValueFactory.toString(root));
            // 预期输出: {name: "developer", age: 28, tags: ["java", "serialization"]}
        }
    }
}
当 POJO 字段包含 null 值时序列化行为如何
当自定义 POJO 中的字段值为 null 时,MessagePack 的默认行为取决于所使用的模板生成策略。如果使用基于反射的 Templates.tupleTemplate,它通常会忽略 null 字段,不将其写入二进制流中,从而进一步节省空间。这意味着反序列化后,缺失的字段将保持默认值(如 null 引用或基本类型的零值),而不是恢复为原始对象中的 null 状态。这种行为在处理可选字段时非常高效,但开发者需注意在反序列化端进行空值检查,因为二进制流中根本不存在该字段的痕迹。


















