








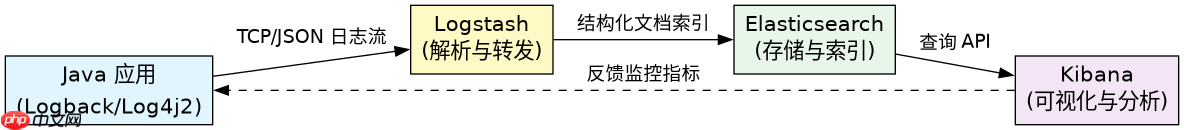
java 日志记录使用 elk 分析的核心做法是:在 java 应用中集成 logstash tcp/udp appender 或 filebeat,将结构化日志直接发送至 elasticsearch。通过配置 logback 或 log4j2 输出 json 格式日志,并利用 kibana 创建索引模式与可视化面板,即可实现实时检索、聚合分析与异常监控。
如何配置 Java 应用以发送结构化 JSON 日志
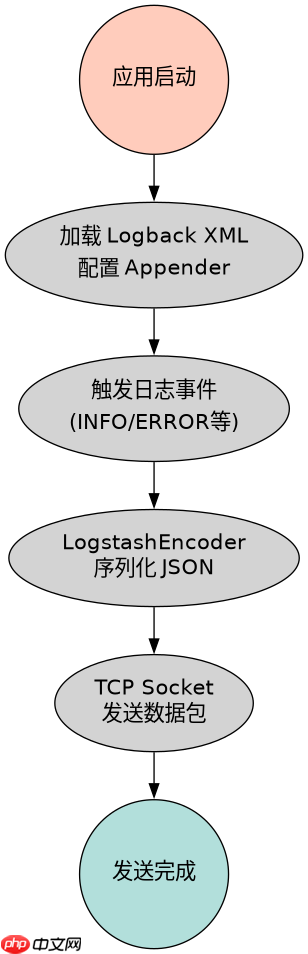
要让 ELK 有效分析日志,必须确保 Java 应用输出的日志是机器可读的 JSON 格式,而非纯文本。这通常通过在 Logback 或 Log4j2 中配置特定的 Layout 和 Appender 来实现。对于 Logback,推荐使用 net.logstash.logback 库提供的 LogstashEncoder,它能自动将 MDC(Mapped Diagnostic Context)中的键值对序列化为 JSON 字段。配置时需指定目标 Logstash 服务器的 IP 和端口,并启用 TCP 协议以保证传输可靠性。这样做的结果是,每条日志都包含时间戳、级别、线程名、类名以及自定义的业务字段,便于后续在 Elasticsearch 中进行精确查询。
<configuration>
    <appender name="LOGSTASH" class="net.logstash.logback.appender.LogstashTcpSocketAppender">
        <destination>192.168.1.100:5000</destination>
        <encoder class="net.logstash.logback.encoder.LogstashEncoder" />
    </appender>
    <root level="INFO">
        <appender-ref ref="LOGSTASH" />
    </root>
</configuration>
上述配置片段展示了 Logback 的基础设置。关键点在于 LogstashTcpSocketAppender 负责建立网络连接,而 LogstashEncoder 负责数据格式化。开发者需确保项目中引入了对应的 Maven 依赖:net.logstash.logback:logstash-logback-encoder。当应用启动后,所有符合 INFO 及以上级别的日志都会通过网络发送到指定的 Logstash 实例。若需添加业务上下文,可在代码中使用 MDC.put("userId", "123"),该字段会自动出现在生成的 JSON 日志中。
立即学习“Java免费学习笔记(深入)”;

在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
如何在 Logstash 中解析并索引 JSON 日志
Logstash 作为中间件,主要职责是从 Java 应用接收原始 JSON 字符串,并将其转换为 Elasticsearch 可索引的结构化文档。这一步骤的关键在于编写正确的 Grok 或 JSON 过滤器插件配置。由于 Java 端已经输出了标准 JSON,Logstash 配置应优先使用 json { source => "message" } 指令来解析消息体。如果 JSON 中包含嵌套对象,Logstash 会自动将其展平或保留为数组结构。此外,需要配置 elasticsearch 输出插件,指定 ES 集群的地址、索引名称以及可能的用户认证信息。经过这一层处理后,日志数据将以文档形式存储在 Elasticsearch 中,每个文档对应一条日志记录,字段名与 JSON 键名一致。

input {
  tcp {
    port => 5000
    codec => json_lines
  }
}
filter {
  json {
    source => "message"
  }
}
output {
  elasticsearch {
    hosts => ["http://localhost:9200"]
    index => "java-app-logs-%{+YYYY.MM.dd}"
  }
}
这段 Logstash Pipeline 配置定义了从输入到输出的完整流程。tcp 输入源监听 5000 端口,并使用 json_lines 编解码器,这意味着它期望每行都是一个完整的 JSON 对象。filter 部分使用 json 插件解析 message 字段,提取其中的键值对。最后,output 将处理后的数据写入 Elasticsearch,索引名称按天滚动,便于管理历史数据。开发者需注意,若 Java 端未正确关闭连接或发送非 JSON 数据,可能导致解析失败,此时可结合 mutate 插件进行错误处理或丢弃无效日志。
基于 MDC 上下文的日志追踪如何实现
在分布式系统中,单一请求可能跨越多个服务,因此利用 MDC(Mapped Diagnostic Context)注入 TraceID 是实现链路追踪的关键。Java 应用应在请求入口处生成唯一的 TraceID,并通过 MDC 将其绑定到当前线程。随后,所有日志框架都会自动将该 ID 附加到每条日志的 JSON 输出中。在 Kibana 中,可以通过构建基于 trace_id 字段的过滤视图,快速定位某个特定请求在所有服务中的完整日志流。这种方法无需修改底层日志库,仅需在业务代码中增加少量的上下文管理逻辑,即可显著提升故障排查效率。



















