








在 java 中排查调用链路的核心做法是捕获异常后,通过 printstacktrace() 或遍历 getstacktrace() 获取堆栈信息,从而还原方法调用的先后顺序。开发者只需在业务逻辑的入口或关键节点打印堆栈,即可明确异常是从哪个类、哪一行代码触发的,进而定位问题根源。
如何从异常对象中提取完整的调用栈数据
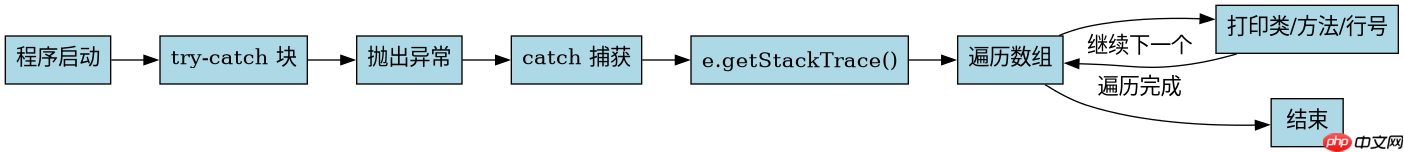
直接调用异常的 getStackTrace() 方法可以返回一个 StackTraceElement 数组,该数组按从最新到最旧的顺序排列,索引 0 即为抛出异常的方法。通过遍历这个数组,可以精确获取每个调用点的类名、方法名和行号,这是构建调用链可视化的基础数据来源。
import java.util.Arrays;

public class StackTraceAnalyzer {
    public static void main(String[] args) {
        try {
            methodA();
        } catch (Exception e) {
            // 获取堆栈元素数组
            StackTraceElement[] stack = e.getStackTrace();
            System.out.println("调用链路长度: " + stack.length);
            for (int i = 0; i < stack.length; i++) {
                System.out.println(i + ": " + stack[i]);
            }
        }
    }

    private static void methodA() {
        methodB();
    }

    private static void methodB() {
        throw new RuntimeException("Test Exception");
    }
}
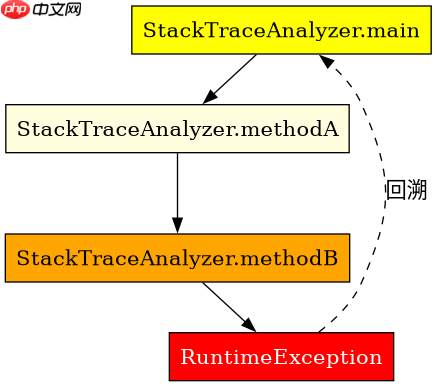
运行上述代码将输出类似如下的结果,清晰展示了从 main 到 methodA 再到 methodB 的调用顺序:

在架构漂移扩散之前,使用 dependency-cruiser 强制执行 JavaScript 和 TypeScript 依赖规则
下载
在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
立即学习“Java免费学习笔记(深入)”;
调用链路长度: 3
0: com.example.StackTraceAnalyzer.methodB(StackTraceAnalyzer.java:24)
1: com.example.StackTraceAnalyzer.methodA(StackTraceAnalyzer.java:19)
2: com.example.StackTraceAnalyzer.main(StackTraceAnalyzer.java:10)
如何利用自定义异常封装调用链上下文信息
自定义异常可以通过构造函数接收额外的上下文参数(如用户 ID、请求流水号),并在初始化时将这些信息附加到异常消息中。这样在捕获异常时,不仅能看到堆栈轨迹,还能立即获得业务层面的关键线索,无需额外查询数据库或日志系统即可初步判断故障场景。

public class ContextAwareException extends Exception {
    private final String requestId;

    public ContextAwareException(String message, String requestId, Throwable cause) {
        super(message + " [RequestID: " + requestId + "]", cause);
        this.requestId = requestId;
    }

    public String getRequestId() {
        return requestId;
    }
}

// 使用示例
try {
    processOrder("ORD-123");
} catch (ContextAwareException e) {
    System.err.println(e.getMessage()); // 包含 RequestID
    System.err.println(e.getRequestId()); // 直接获取 ID
}
当自定义异常被多层包装时如何追踪原始错误源
如果自定义异常在传递过程中被其他异常包装(例如外层捕获后抛出新的 RuntimeException),直接查看外层异常的堆栈会丢失原始位置。此时应使用 getCause() 方法递归向下查找,直到找到根因异常。通过编写一个简单的递归解析器,可以提取出所有嵌套层级中的关键调用点,形成一条完整的“异常溯源链”。



















