








Java 线程池中 怎么获取线程池完成任务数
java 标准库中的 threadpoolexecutor 没有直接暴露“已完成任务总数”的公开方法,因为该计数器属于内部状态。要获取这个数值,最直接的做法是继承 threadpoolexecutor 并重写 afterexecute 方法,在每次任务执行完毕后手动累加一个静态或实例变量。

如何区分成功完成与异常终止的任务
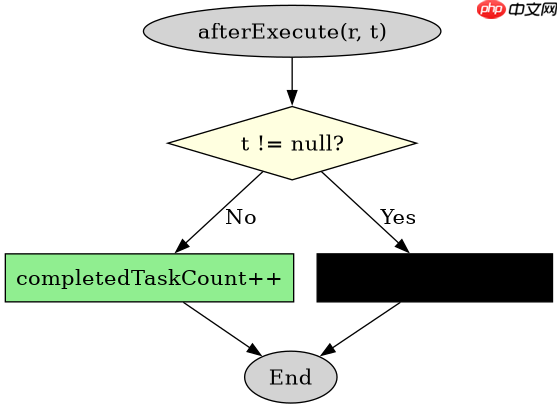
在重写 afterExecute 时,可以通过检查传入的 Throwable 参数来判断任务是否因异常而终止。如果该参数不为空,说明任务执行过程中抛出了未捕获的异常;如果为空,则说明任务正常结束。这种机制允许你分别统计成功和失败的任务数。
基于程序中某个输入、条件或结果的具体问题
当线程池关闭后,通过上述方式统计的计数器将不再增加。如果在主线程中需要获取最终的完成总数,必须在调用 shutdown() 并等待 awaitTermination() 完成后,再读取该计数器变量的值。否则,由于任务可能仍在队列中排队或正在执行,读取到的数值是不完整的。
立即学习“Java免费学习笔记(深入)”;
import java.util.concurrent.*;

public class CustomThreadPool extends ThreadPoolExecutor {
    private long completedTaskCount = 0;
    private long failedTaskCount = 0;

    public CustomThreadPool(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue) {
        super(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue);
    }

    @Override
    protected void afterExecute(Runnable r, Throwable t) {
        super.afterExecute(r, t);
        if (t == null) {
            completedTaskCount++;
        } else {
            failedTaskCount++;
        }
    }

    public long getCompletedTaskCount() {
        return completedTaskCount;
    }

    public long getFailedTaskCount() {
        return failedTaskCount;
    }

    public static void main(String[] args) throws InterruptedException {
        CustomThreadPool executor = new CustomThreadPool(2, 4, 60L, TimeUnit.SECONDS, new LinkedBlockingQueue<>());

        for (int i = 0; i < 5; i++) {
            final int taskId = i;
            executor.submit(() -> {
                if (taskId == 2) {
                    throw new RuntimeException("Simulated Error");
                }
                System.out.println("Task " + taskId + " completed");
            });
        }

        executor.shutdown();
        executor.awaitTermination(1, TimeUnit.MINUTES);

        System.out.println("Completed: " + executor.getCompletedTaskCount());
        System.out.println("Failed: " + executor.getFailedTaskCount());
    }
}
运行上述代码,预期输出如下:
Task 0 completed
Task 1 completed
Task 3 completed
Task 4 completed
Completed: 4
Failed: 1
在这个示例中,我们创建了一个自定义的线程池,重写了 afterExecute 方法来追踪任务状态。主线程提交了 5 个任务,其中任务 2 会抛出异常。程序最后打印出成功完成的任务数为 4,失败的任务数为 1。这验证了通过 afterExecute 可以准确区分任务的执行结果。
需要注意的是,completedTaskCount 和 failedTaskCount 是普通变量,在多线程环境下可能存在竞态条件。对于高并发场景,建议使用 AtomicLong 来替代普通 long 类型,以确保计数的原子性和可见性。例如,将 private long completedTaskCount = 0; 改为 private AtomicLong completedTaskCount = new AtomicLong(0);,并在 afterExecute 中使用 completedTaskCount.incrementAndGet()。
此外,ThreadPoolExecutor 本身提供了 getCompletedTaskCount() 方法,但该方法返回的是 long 类型的近似值,且文档明确指出它主要用于监控和调试,其精度可能不如自定义计数器高,因为它不保证在任务提交和执行之间的严格一致性。因此,对于需要精确计数的业务场景,推荐采用上述继承并重写 afterExecute 的方案。
如果使用的是 Java 8 及以上版本,还可以考虑使用 CompletableFuture 结合线程池来实现更复杂的任务编排和结果收集,但这通常适用于需要获取任务返回值的场景,而非单纯的计数需求。对于纯计数场景,自定义线程池是最轻量且可控的方式。
总结来说,获取线程池完成任务数的关键在于拦截任务的执行生命周期。通过继承 ThreadPoolExecutor 并重写 afterExecute,可以在任务结束后立即更新计数器。这种方式简单、直接,并且能够灵活地区分成功和失败的任务。在实际应用中,务必注意线程安全问题,使用原子类或同步机制来保护计数器变量。
另外,ThreadPoolExecutor 的 getActiveCount() 和 getQueue().size() 方法可以用来监控当前活跃线程数和队列中的待处理任务数,但这些并不能直接反映已完成的任务总数。因此,自定义计数器仍然是获取已完成任务总数的最佳实践。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
最后,确保在应用程序关闭时正确关闭线程池,以避免资源泄漏。调用 shutdown() 后,线程池将停止接受新任务,并等待已提交的任务完成。此时,自定义计数器将反映所有已处理任务的最终状态。
通过以上方法,你可以准确地跟踪线程池中任务的完成情况,从而更好地监控和管理你的并发应用。
在实际开发中,建议将自定义线程池封装成一个工具类,提供统一的接口来获取任务统计信息,这样可以提高代码的可维护性和复用性。
例如,可以创建一个 TaskMonitor 类,包含对 CustomThreadPool 的引用,并提供 getStats() 方法来返回一个包含各种统计信息的对象。这样,其他模块就可以方便地获取线程池的运行状态,而不需要直接访问线程池的内部细节。
总之,通过自定义线程池并重写 afterExecute 方法,我们可以有效地获取线程池完成任务数,并根据需要进行进一步的分析和监控。这种方法不仅适用于简单的计数需求,还可以扩展为更复杂的任务追踪和分析系统。
希望本文能帮助你解决在 Java 线程池中获取完成任务数的问题。如果你有任何其他疑问或需要进一步的帮助,请随时提问。
记住,良好的并发编程实践包括对线程池状态的持续监控和适当的错误处理。通过自定义计数器,你可以获得更细粒度的控制,从而构建更健壮和可靠的并发应用。
最后,再次强调,在使用自定义计数器时,务必考虑线程安全,使用原子类或同步机制来保护共享状态,以避免数据竞争和不一致的问题。
祝你编码愉快!
(注:以上代码示例仅供参考,实际使用时请根据具体需求进行调整和优化。)
(完)



















