








java nio 中调用 duplicate() 方法可以创建一个与当前缓冲区共享数据的新缓冲区。新缓冲区与原缓冲区拥有相同的容量、位置(position)、界限(limit)和标记(mark),但它们是独立的对象,修改其中一个的元数据不会影响另一个。底层存储的数据是共用的,因此对数据的修改会反映在两个缓冲区上。
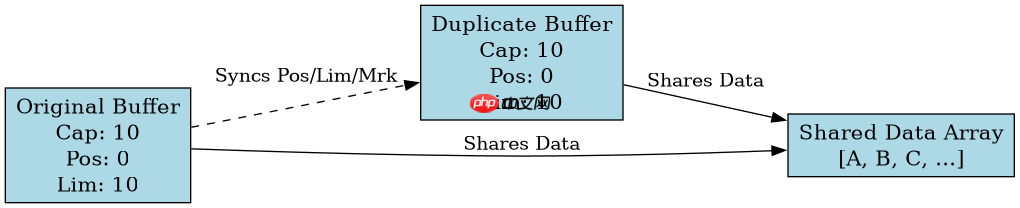
duplicate() 创建后的缓冲区状态如何
调用 duplicate() 后,新缓冲区与原缓冲区在位置、界限和标记上完全同步。这意味着如果你移动了原缓冲区的位置,新缓冲区的位置也会随之改变,反之亦然。这种同步机制使得 duplicate() 非常适合用于需要同时从不同角度处理同一块内存数据的场景,例如一个线程负责读取数据,另一个线程负责解析数据,它们共享同一份数据源但各自维护自己的处理进度。
import java.nio.ByteBuffer;

public class DuplicateDemo {
    public static void main(String[] args) {
        // 创建一个容量为 10 的 ByteBuffer
        ByteBuffer original = ByteBuffer.allocate(10);

        // 写入一些数据
        for (int i = 0; i < 5; i++) {
            original.put((byte) ('A' + i));
        }

        // 翻转缓冲区,准备读取
        original.flip();

        System.out.println("Original Position: " + original.position());
        System.out.println("Original Limit: " + original.limit());

        // 创建副本
        ByteBuffer duplicate = original.duplicate();

        // 移动副本的位置
        duplicate.position(2);

        // 检查原缓冲区的位置是否改变
        System.out.println("After Duplicate Move:");
        System.out.println("Original Position: " + original.position());
        System.out.println("Duplicate Position: " + duplicate.position());

        // 读取数据验证共享性
        System.out.print("Data from Original: ");
        while (original.hasRemaining()) {
            System.out.print((char) original.get() + " ");
        }
        System.out.println();

        // 重置原缓冲区位置以便再次读取
        original.rewind();

        System.out.print("Data from Duplicate: ");
        while (duplicate.hasRemaining()) {
            System.out.print((char) duplicate.get() + " ");
        }
    }
}
运行上述代码,输出结果如下:
Original Position: 5
Original Limit: 10
After Duplicate Move:
Original Position: 2
Duplicate Position: 2
Data from Original: C D E
Data from Duplicate: C D E
可以看到,当
duplicate 的位置移动到 2 时,original 的位置也变成了 2。两者读取到的数据都是从索引 2 开始的 'C', 'D', 'E',证明了数据是共享的,且位置状态是同步的。
duplicate() 与 slice() 的区别是什么
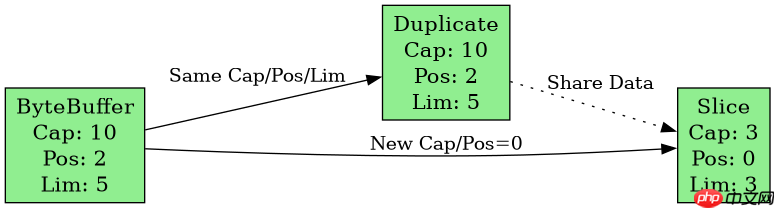
duplicate() 和 slice() 都创建共享数据的缓冲区,但关键区别在于容量的继承方式。duplicate() 创建的缓冲区容量与原缓冲区相同,而 slice() 创建的缓冲区容量等于原缓冲区剩余数据的长度(即 limit - position)。此外,slice() 的位置始终从 0 开始,而 duplicate() 的位置继承自原缓冲区。这使得 slice() 更适合提取当前有效数据子集进行处理,而 duplicate() 更适合对整个数据进行并行或独立视角的处理。

在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
立即学习“Java免费学习笔记(深入)”;
import java.nio.ByteBuffer;

public class SliceVsDuplicate {
    public static void main(String[] args) {
        ByteBuffer buffer = ByteBuffer.allocate(10);
        for (int i = 0; i < 5; i++) {
            buffer.put((byte) ('A' + i));
        }
        buffer.flip();

        // 移动位置到 2
        buffer.position(2);

        // 创建 duplicate
        ByteBuffer dup = buffer.duplicate();

        // 创建 slice
        ByteBuffer slice = buffer.slice();

        System.out.println("Buffer Capacity: " + buffer.capacity());
        System.out.println("Buffer Position: " + buffer.position());
        System.out.println("Buffer Limit: " + buffer.limit());

        System.out.println("Dup Capacity: " + dup.capacity());
        System.out.println("Dup Position: " + dup.position());
        System.out.println("Dup Limit: " + dup.limit());

        System.out.println("Slice Capacity: " + slice.capacity());
        System.out.println("Slice Position: " + slice.position());
        System.out.println("Slice Limit: " + slice.limit());

        // 修改 slice 的内容
        slice.put(0, (byte) 'X');

        // 检查原缓冲区内容是否改变
        buffer.position(2); // 确保位置正确
        System.out.println("Original Data at pos 2: " + (char) buffer.get());
    }
}
运行结果:
Buffer Capacity: 10
Buffer Position: 2
Buffer Limit: 5
Dup Capacity: 10
Dup Position: 2
Dup Limit: 5
Slice Capacity: 3
Slice Position: 0
Slice Limit: 3
Original Data at pos 2: X
可以看出,
dup 继承了原缓冲区的容量(10)和位置(2),而 slice 的容量仅为剩余数据长度(3),且位置从 0 开始。两者都共享数据,因此修改 slice 会影响原缓冲区。
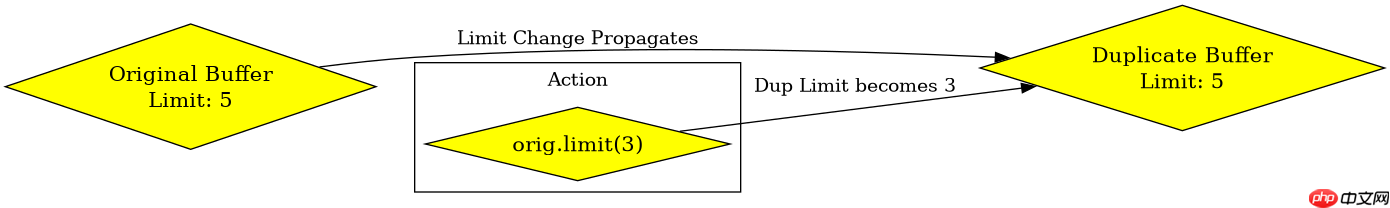
使用 duplicate() 时如果修改了原缓冲区的界限会发生什么
由于 duplicate() 创建的缓冲区与原缓冲区共享界限(limit)和位置(position),任何对原缓冲区界限的修改都会立即反映在副本上。如果原缓冲区的界限被缩小,副本的有效数据范围也会相应缩小;如果界限被扩大,副本也能访问到新扩展的区域(前提是底层数组有足够空间)。这种紧密耦合意味着在使用 duplicate() 时,必须谨慎管理原缓冲区的界限,以避免意外影响副本的数据访问范围。



















