








java 中的 hashset 底层基于 hashmap 实现,不是线程安全的。在多线程环境下直接并发修改会导致数据竞争、逻辑错误甚至死循环(jdk 7 及以前)。处理并发的标准做法是使用 collections.synchronizedset() 包装类,或者使用 concurrenthashmap 配合 concurrentskiplistset / 自定义同步块来实现高并发读写。
为什么 HashSet 并发会出问题
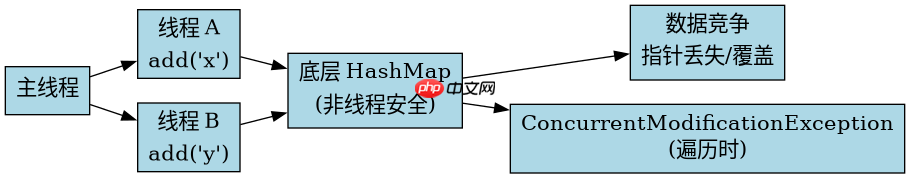
HashSet 的线程不安全主要源于其底层 HashMap 的非原子性操作。当多个线程同时调用 add() 方法时,如果发生哈希冲突且位于同一个桶中,线程 A 可能在计算链表/红黑树结构时被线程 B 打断,导致指针丢失或形成环状结构。此外,迭代器在遍历过程中若检测到结构被修改,会抛出 ConcurrentModificationException。这种失败是静默的或异常的,取决于 JDK 版本和具体操作,无法通过简单的重试解决。
import java.util.HashSet;
import java.util.Set;
import java.util.Collections;

public class UnsafeHashSetDemo {
    public static void main(String[] args) {
        // 非线程安全的 HashSet
        Set<String> unsafeSet = new HashSet<>();

        Thread t1 = new Thread(() -> {
            for (int i = 0; i < 1000; i++) {
                unsafeSet.add("Thread-1-" + i);
            }
        });

        Thread t2 = new Thread(() -> {
            for (int i = 0; i < 1000; i++) {
                unsafeSet.add("Thread-2-" + i);
            }
        });

        t1.start();
        t2.start();
        try {
            t1.join();
            t2.join();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

        System.out.println("Size: " + unsafeSet.size());
        // 预期结果:可能小于 2000,因为存在覆盖或丢失
        // 实际行为:数据不一致,无异常抛出但计数错误
    }
}
如何安全地处理并发 HashSet
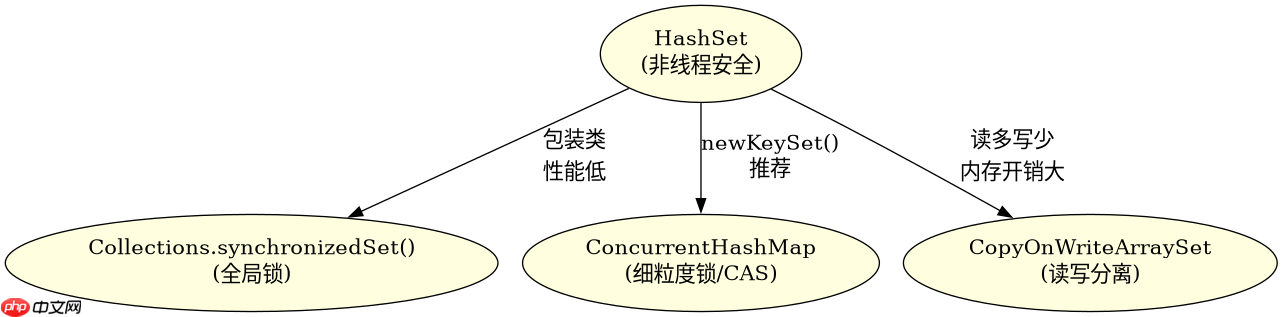
最直接的解决方案是使用 Collections.synchronizedSet()。该方法返回一个线程安全的包装类,所有方法调用都带有内置锁。虽然简单,但在高并发场景下性能较差,因为每次操作都需要获取全局锁。另一种更高效的方案是使用 ConcurrentHashMap 作为底层存储,结合 ConcurrentSkipListSet 或使用 CopyOnWriteArraySet(适用于读多写少且元素较少的场景)。对于大多数需要高并发写入的场景,推荐使用 ConcurrentHashMap.newKeySet(),它利用了 ConcurrentHashMap 的细粒度锁机制,支持更高的吞吐量。

在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
立即学习“Java免费学习笔记(深入)”;
import java.util.Set;
import java.util.concurrent.ConcurrentHashMap;
import java.util.concurrent.CopyOnWriteArraySet;

public class SafeHashSetDemo {
    public static void main(String[] args) {
        // 方案一:Collections 包装(简单但慢)
        Set<String> syncSet = Collections.synchronizedSet(new HashSet<>());

        // 方案二:ConcurrentHashMap KeySet(推荐,高性能)
        Set<String> concurrentSet = ConcurrentHashMap.newKeySet();

        // 方案三:CopyOnWriteArraySet(读多写少)
        Set<String> cowSet = new CopyOnWriteArraySet<>();

        // 验证并发安全性
        Thread t1 = new Thread(() -> {
            for (int i = 0; i < 1000; i++) {
                concurrentSet.add("C-" + i);
            }
        });

        Thread t2 = new Thread(() -> {
            for (int i = 0; i < 1000; i++) {
                concurrentSet.add("D-" + i);
            }
        });

        t1.start();
        t2.start();
        try {
            t1.join();
            t2.join();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

        System.out.println("Concurrent Size: " + concurrentSet.size());
        // 预期结果:2000
        // 实际行为:准确计数为 2000,无数据丢失
    }
}
ConcurrentHashMap.newKeySet() 的具体实现细节
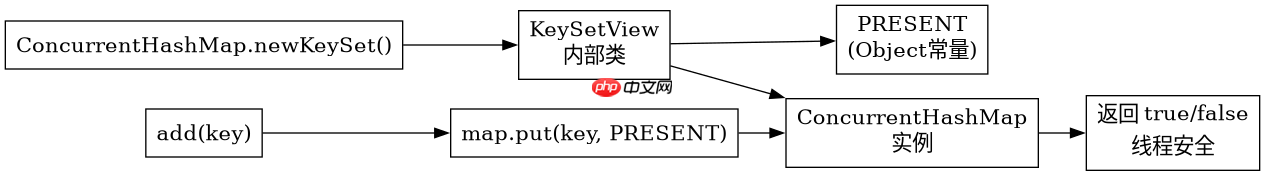
ConcurrentHashMap.newKeySet() 返回的是一个内部类 KeySetView 的实例。它并不创建新的数据结构,而是复用 ConcurrentHashMap 的键集合视图。当调用 add() 时,它实际上调用的是 map.put(key, PRESENT),其中 PRESENT 是一个静态的 Object 常量。由于 ConcurrentHashMap 的 put 方法是线程安全的,因此 add 操作也是线程安全的。这种设计避免了额外的内存开销,并且利用了 ConcurrentHashMap 的分段锁或 CAS 操作来保证并发性能。需要注意的是,KeySetView 不支持 null 键,这与 ConcurrentHashMap 的限制一致。


















