








java jdbc 实现批量数据脱敏的核心做法是:在开启事务后,通过 preparedstatement 将原始数据在内存中转换为脱敏格式,再使用 addbatch() 累积操作,最后调用 executebatch() 一次性提交。这样做既能保证数据的原子性,又能利用批量接口减少网络交互开销。若需处理大量数据,建议分批次执行以避免内存溢出。
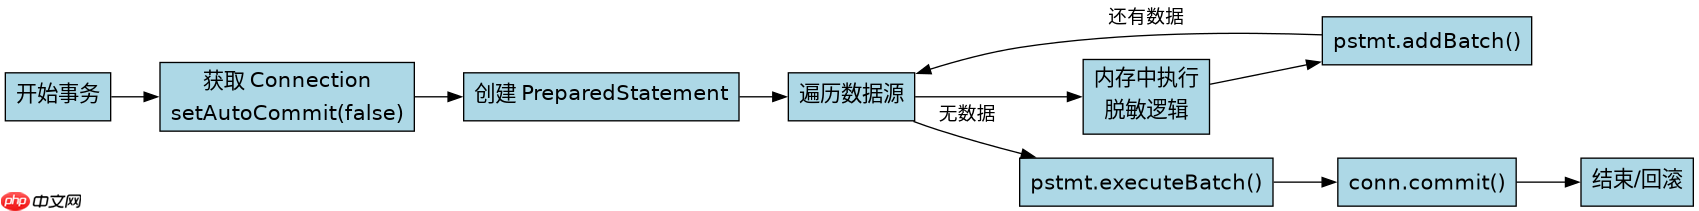
JDBC 事务与批处理的结合流程是怎样的
该流程展示了从获取连接、关闭自动提交到最终提交的完整生命周期。重点在于 Connection 对象的状态管理以及 Statement 的复用。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class BatchMaskingDemo {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        // 模拟待脱敏的数据列表
        String[] rawPhoneNumbers = {"13800138000", "13900139000", "13700137000"};

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交,开启事务
            conn.setAutoCommit(false);

            String sql = "UPDATE users SET phone = ? WHERE id = ?";
            // 2. 预编译 SQL,提高批量执行效率
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < rawPhoneNumbers.length; i++) {
                    // 3. 内存中执行脱敏逻辑
                    String maskedPhone = maskPhone(rawPhoneNumbers[i]);

                    // 4. 设置参数并加入批量队列
                    pstmt.setString(1, maskedPhone);
                    pstmt.setInt(2, i + 1); // 假设 ID 为 1, 2, 3
                    pstmt.addBatch();
                }

                // 5. 执行批量更新
                int[] results = pstmt.executeBatch();

                // 6. 提交事务
                conn.commit();
                System.out.println("批量脱敏完成,影响行数:" + results.length);

            } catch (SQLException e) {
                // 发生异常时回滚事务
                conn.rollback();
                throw e;
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    // 简单的手机号脱敏方法
    private static String maskPhone(String phone) {
        if (phone == null || phone.length() != 11) {
            return phone;
        }
        return phone.substring(0, 3) + "****" + phone.substring(7);
    }
}
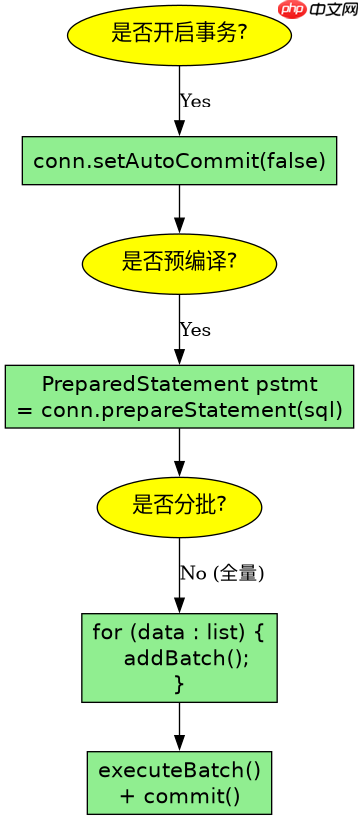
上述代码演示了标准的 JDBC 批量脱敏模式。首先通过 setAutoCommit(false) 禁用自动提交,确保后续操作处于同一事务中。接着创建 PreparedStatement,在循环中对每个原始数据进行脱敏处理(如手机号中间四位替换为星号),并通过 addBatch() 将参数加入队列。最后调用 executeBatch() 发送所有更新,若成功则 commit(),若失败则 rollback()。
立即学习“Java免费学习笔记(深入)”;

在代码库出现结构漂移之前,扫描JS或TS代码库中的禁止导入、循环依赖、孤立模块和其他依赖规则违规情况。
如何处理大批量数据以避免内存溢出
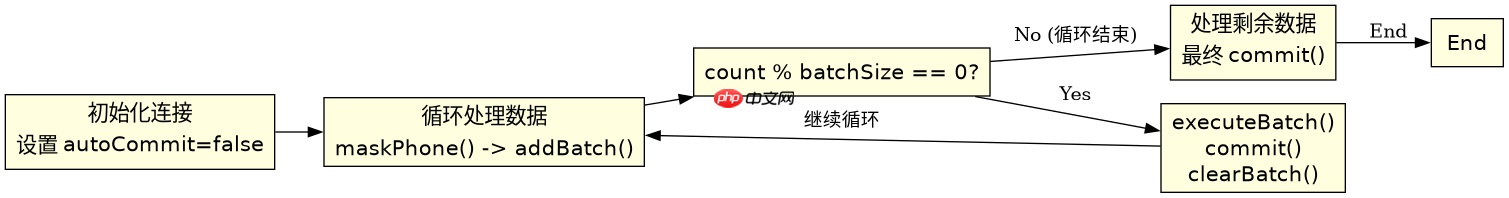
当数据量达到数万条以上时,一次性将所有数据加入 addBatch() 会导致 JVM 堆内存溢出。此时应采用分片策略,每处理固定数量的记录就执行一次 executeBatch() 并提交事务。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;
import java.util.List;
import java.util.ArrayList;

public class ChunkedMaskingDemo {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        // 模拟大量数据
        List<String> allPhones = new ArrayList<>();
        for (int i = 0; i < 100000; i++) {
            allPhones.add("138" + String.format("%08d", i));
        }

        int batchSize = 1000; // 每批处理 1000 条

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "UPDATE users SET phone = ? WHERE id = ?";

            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                int count = 0;
                for (int i = 0; i < allPhones.size(); i++) {
                    String maskedPhone = maskPhone(allPhones.get(i));
                    pstmt.setString(1, maskedPhone);
                    pstmt.setInt(2, i + 1);
                    pstmt.addBatch();
                    count++;

                    // 达到批次大小时执行并提交
                    if (count % batchSize == 0) {
                        pstmt.executeBatch();
                        conn.commit();
                        pstmt.clearBatch(); // 清空已执行的批次
                        System.out.println("已处理 " + (i + 1) + " 条数据");
                    }
                }

                // 处理剩余不足一批的数据
                if (count % batchSize != 0) {
                    pstmt.executeBatch();
                    conn.commit();
                }
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    private static String maskPhone(String phone) {
        if (phone == null || phone.length() != 11) return phone;
        return phone.substring(0, 3) + "****" + phone.substring(7);
    }
}
分块处理的关键在于控制 addBatch() 的累积数量。代码中设定 batchSize 为 1000,每当计数器达到该值时,立即调用 executeBatch() 和 commit(),随后使用 clearBatch() 释放内存。这种方式虽然增加了事务提交的次数,但显著降低了单次事务的大小和内存占用,适合生产环境中的大数据量脱敏场景。
脱敏后的数据在数据库中是如何存储的
脱敏操作是在应用层完成的,数据库仅接收转换后的字符串。例如,原始手机号 13800138000 会被转换为 138****8000 并存入 phone 字段。由于脱敏逻辑在 Java 代码中实现,数据库本身不感知原始数据,只负责存储最终的脱敏结果。这种设计确保了即使数据库管理员直接查询数据库,也无法获取敏感信息的明文。



















