








如何监控 Nginx 缓冲区内存占用与溢出日志
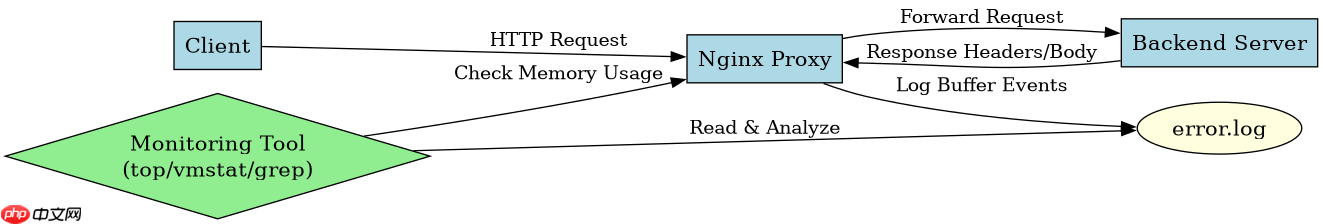
nginx 通过访问日志中的 $upstream_status 和 $upstream_cache_status 等变量,结合系统工具如 top、vmstat 或 nginx -v 查看编译参数来监控缓冲区状态。要获取溢出日志,需开启 proxy_buffering off; 或在错误日志中配置 error_log /var/log/nginx/error.log warn; 以捕获缓冲区相关警告。实际做法是检查 /var/log/nginx/error.log 中是否有 upstream prematurely closed connection 或 buffer size exceeds maximum 类型的记录,并通过 tail -f 实时观察。
如何通过日志分析缓冲区溢出事件
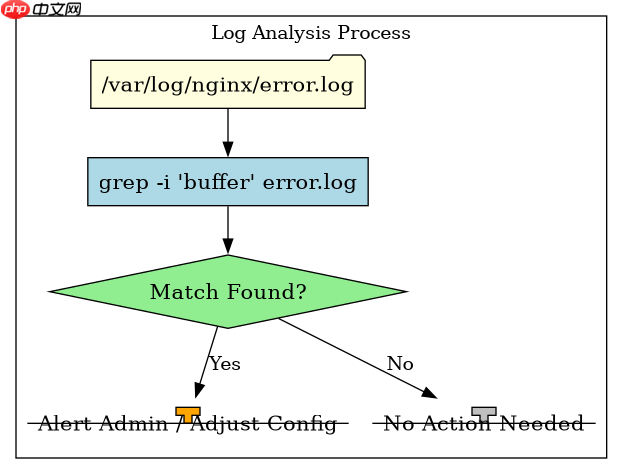
通过分析 Nginx 错误日志中的特定关键字,可以定位缓冲区溢出事件。主要关注 error.log 文件,使用 grep 命令筛选包含 buffer 或 upstream 的行。例如,执行 grep -i "buffer" /var/log/nginx/error.log 可列出所有缓冲区相关错误。若发现 client intended to send too large body,则说明请求体超出 client_max_body_size 限制;若出现 upstream sent too big header,则表明后端响应头超过 proxy_buffer_size 或 proxy_buffers 设置。这些日志条目通常带有时间戳和客户端 IP,便于追踪具体请求来源。

#!/bin/bash
# 监控 Nginx 缓冲区溢出日志脚本
LOG_FILE="/var/log/nginx/error.log"
BUFFER_KEYWORDS="buffer upstream prematurely closed connection client intended to send too large body upstream sent too big header"

echo "开始监控 Nginx 缓冲区相关日志..."
tail -f "$LOG_FILE" | while read line; do
    for keyword in $BUFFER_KEYWORDS; do
        if echo "$line" | grep -qi "$keyword"; then
            echo "[ALERT] $(date '+%Y-%m-%d %H:%M:%S') - $line"
        fi
    done
done
当 proxy_buffer_size 设置过小时会发生什么
当 proxy_buffer_size 设置过小时,Nginx 无法完整接收后端服务器返回的 HTTP 响应头,导致连接被提前关闭或返回 502 Bad Gateway 错误。此时,error.log 中会记录类似 upstream sent too big header while reading response header from upstream 的警告信息。该问题常见于后端应用返回大量 Cookie 或自定义 Header 的场景。解决方法是增大 proxy_buffer_size 的值,例如设置为 4k 或 8k,并确保其与 proxy_buffers 的配置协调一致,以避免内存浪费或溢出。





















