








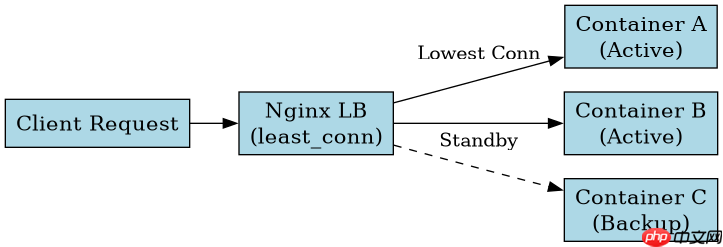
在容器环境中优化 nginx 的 least_conn 策略,核心在于解决因容器网络隔离导致的后端健康检查失效和连接数统计不准问题。具体做法是结合 proxy_next_upstream 配置实现故障自动转移,并配合 upstream 模块的健康检查机制确保流量只分发到活跃节点。通过合理设置超时时间和重试次数,可以显著提升高并发场景下的服务稳定性。
如何配置 upstream 以支持动态发现与负载均衡
在容器化部署中,Nginx 需要能够感知后端服务的变化。使用 least_conn 时,必须确保上游服务器列表是准确的。通过在 upstream 块中定义服务器组,并启用 zone 共享内存,可以实现多进程间的连接数同步。同时,建议将后端服务标记为 backup 或设置权重,以应对突发流量。这种配置方式让 Nginx 能够基于实时连接数而非静态轮询来分配请求,从而避免单个容器过载。
worker_processes auto;
events {
    worker_connections 1024;
}
http {
    upstream backend_pool {
        least_conn;
        zone my_zone 64k;
        server 10.0.0.1:8080 max_fails=3 fail_timeout=10s;
        server 10.0.0.2:8080 max_fails=3 fail_timeout=10s;
        server 10.0.0.3:8080 backup;
    }

    server {
        listen 80;
        location / {
            proxy_pass http://backend_pool;
            proxy_connect_timeout 5s;
            proxy_read_timeout 30s;
        }
    }
}
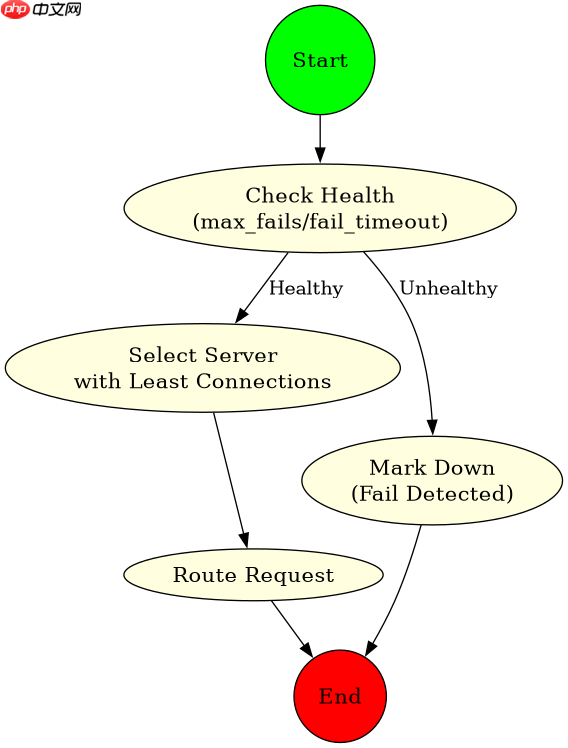
上述配置中,zone my_zone 64k 确保了多个 worker 进程能共享连接状态。max_fails 和 fail_timeout 参数用于快速剔除异常节点。当某个容器不可用时,Nginx 会自动将其从可用列表中移除,直到恢复。这种机制比单纯的 least_conn 更健壮,因为它结合了健康检查逻辑。

如何通过 proxy_next_upstream 增强容错能力
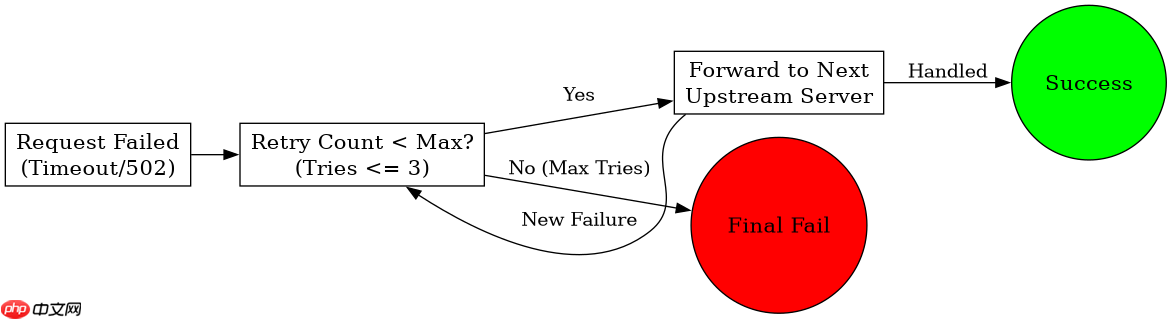
仅靠 least_conn 无法处理传输过程中的瞬时错误。在容器环境中,网络抖动或服务重启可能导致请求失败。此时,proxy_next_upstream 指令至关重要。它允许 Nginx 在遇到特定错误(如超时、502 Bad Gateway)时,自动将请求转发给下一个可用的后端服务器。这相当于在负载均衡层增加了重试机制,提高了整体可用性。需要注意的是,应谨慎设置 error 和 timeout 选项,避免无限重试导致雪崩效应。
server {
    listen 80;
    location /api/ {
        proxy_pass http://backend_pool;
        proxy_next_upstream error timeout invalid_header http_500 http_502 http_503;
        proxy_next_upstream_tries 3;
        proxy_next_upstream_timeout 10s;
    }
}
在这个配置片段中,proxy_next_upstream_tries 3 限制了最大重试次数为 3 次。proxy_next_upstream_timeout 10s 规定了重试总耗时不超过 10 秒。这些参数共同作用,确保即使部分容器出现故障,请求也能在短时间内找到替代路径完成处理。对于长连接或流式传输,建议排除 sendfile 相关错误,以免引发不必要的重试。
在容器环境下如何处理 keepalive 连接对 least_conn 的影响
least_conn 算法依赖于当前活动的 TCP 连接数。然而,HTTP Keep-Alive 特性会导致连接复用,使得连接数统计出现偏差。如果大量请求复用少量长连接,Nginx 可能会误判某些后端负载较低,从而持续向同一节点发送新请求,造成负载不均。为解决此问题,应在 upstream 中显式配置 keepalive 数量,并限制其最大值。此外,可以考虑禁用客户端到 Nginx 的 Keep-Alive,或调整 keepalive_timeout,以减少长连接对负载均衡决策的干扰。这样能确保 least_conn 基于真实的并发请求量进行调度,而非被复用的连接数误导。




















