








在 nginx 中,加权轮询(weighted round robin)的权重配置是静态的,nginx 原生并不提供实时的后端服务器健康监控指标或动态权重调整功能。要实现基于权重的负载均衡并获取相关监控指标,必须依赖第三方模块(如 `nginx-upstream-jvm-route` 或商业版 nginx plus)或结合外部监控系统(如 prometheus + node exporter + 自定义脚本)。对于开源 nginx,最可行的做法是通过日志解析和外部代理来模拟“监控指标”,并在配置文件中手动设置 `weight` 参数。
如何在 upstream 块中配置静态权重
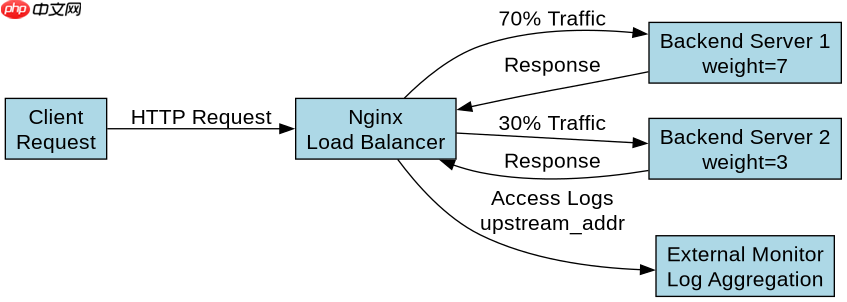
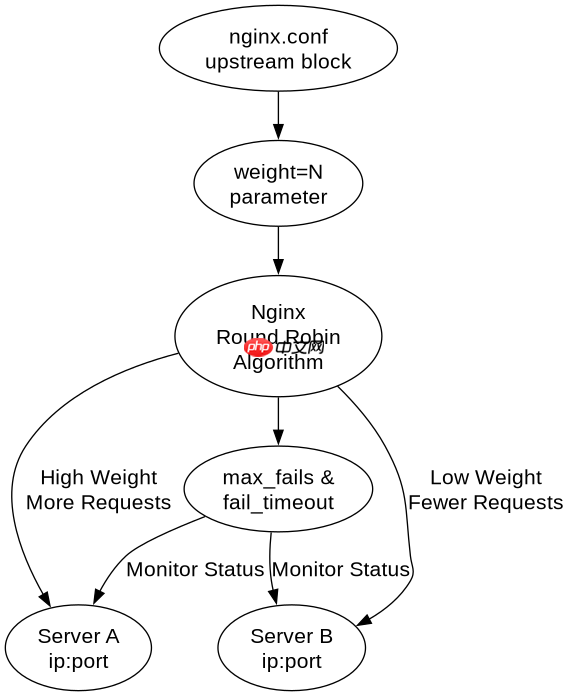
要在 Nginx 中使用加权轮询,需要在 `http` 上下文中定义一个 `upstream` 块,并在其中的 `server` 指令后添加 `weight` 参数。权重值是一个正整数,默认值为 1。权重越高,该服务器被分配请求的概率越大。例如,如果希望 server A 处理 70% 的流量,server B 处理 30% 的流量,可以分别设置 weight=7 和 weight=3。这种配置是静态的,重启 Nginx 或重新加载配置后生效,不会根据服务器当前的负载自动调整。
worker_processes auto;

events {
    worker_connections 1024;
}

http {
    upstream backend_pool {
        # 使用 ip_hash 确保会话保持,同时应用权重
        ip_hash;

        # 配置加权轮询
        server 192.168.1.10:8080 weight=7;
        server 192.168.1.11:8080 weight=3;

        # 可选:设置最大失败次数和超时时间
        max_fails=3;
        fail_timeout=30s;
    }

    server {
        listen 80;
        location / {
            proxy_pass http://backend_pool;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
        }
    }
}
上述配置展示了标准的 Nginx 加权轮询设置。当客户端发起请求时,Nginx 会根据权重比例将请求分发到不同的后端服务器。`max_fails` 和 `fail_timeout` 用于控制故障转移,当某台服务器连续失败达到 `max_fails` 次时,会在 `fail_timeout` 时间内将其从可用列表中移除。这种机制虽然不能提供实时的“监控指标”,但能确保在部分服务器故障时,流量仍能正确路由到健康的服务器上。

如何获取后端服务器的连接与错误指标
由于 Nginx 原生不暴露细粒度的后端服务器监控指标,我们需要通过启用状态页或使用日志格式来间接获取数据。最常用的方法是启用 `stub_status` 模块来获取全局的连接数,但这无法区分后端服务器。要获取每个后端服务器的具体指标,最佳实践是配置访问日志,记录每个请求的目标后端 IP,然后通过外部工具(如 ELK 栈或 Grafana + Loki)进行聚合分析。此外,如果使用 Nginx Plus,可以直接通过 API 获取详细的后端服务器状态、活跃连接数和响应时间等指标。

# 在 http 块中定义日志格式,包含后端服务器信息
log_format upstream_log '$remote_addr - $remote_user [$time_local] '
                        '"$request" $status $body_bytes_sent '
                        '"$http_referer" "$http_user_agent" '
                        'upstream_addr=$upstream_addr '
                        'upstream_response_time=$upstream_response_time';

# 在 server 或 location 块中应用日志格式
server {
    listen 80;
    access_log /var/log/nginx/upstream.log upstream_log;

    location / {
        proxy_pass http://backend_pool;
        # ... 其他配置
    }
}
通过上述日志配置,每次请求都会记录目标后端服务器(`upstream_addr`)及其响应时间(`upstream_response_time`)。这些数据可以被定期采集并存储到时序数据库中,从而构建出类似“监控指标”的视图。例如,可以计算每个后端服务器在单位时间内的请求量、平均响应时间和错误率,进而评估其实际负载情况。如果需要动态调整权重,可以编写脚本定期分析这些指标,并生成新的 Nginx 配置文件,然后执行 `nginx -s reload` 来实现半动态的负载均衡调整。
当后端服务器返回 502 错误时如何排查
当加权轮询配置下的后端服务器返回 502 Bad Gateway 错误时,通常意味着 Nginx 成功将请求转发给了后端服务器,但后端服务器关闭了连接或返回了无效响应。这可能是因为后端服务崩溃、资源耗尽(如内存不足导致进程被杀)、或者防火墙规则阻止了通信。排查步骤包括:首先检查后端服务器的系统日志和应用日志,确认是否有异常退出或错误堆栈;其次,验证 Nginx 配置的 `proxy_connect_timeout` 和 `proxy_read_timeout` 是否合理,过短的超时时间可能导致误判;最后,使用 `curl` 命令直接测试后端服务器的端口连通性和服务状态,排除网络层面的问题。如果某个特定权重的服务器频繁出现 502,可能需要暂时降低其权重或将其标记为 `down`,直到问题解决。

















