








使用 fetch 请求接口时,将 response 的 arraybuffer() 方法作为参数传入,即可获取二进制数据。拿到 arraybuffer 后,通过 url.createobjecturl() 将其转换为 blob url,并赋值给 <a></a> 标签的 href 属性,配合 download 属性即可触发浏览器下载 pdf 文件。

如何配置 fetch 请求以正确接收二进制流
默认情况下,fetch 返回的是文本格式的响应,直接调用 .text() 或 .json() 会导致 PDF 乱码或解析失败。必须显式指定获取类型为 arrayBuffer,确保原始字节流不被编码转换破坏。以下代码展示了完整的请求与处理流程。
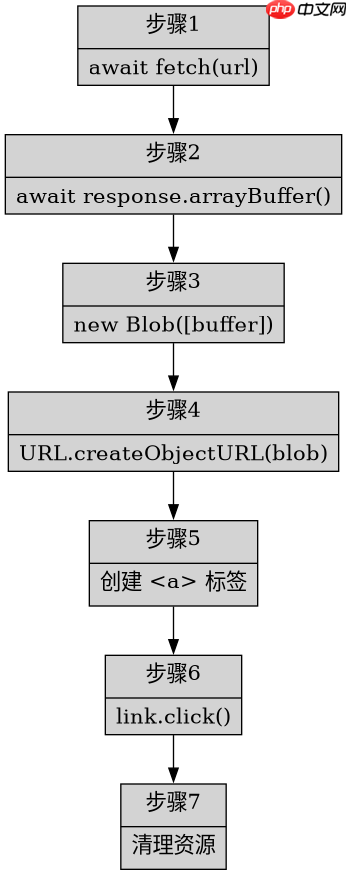
const downloadPdf = async (url) => {
  try {
    const response = await fetch(url);
    if (!response.ok) {
      throw new Error(`HTTP error! status: ${response.status}`);
    }
    // 获取二进制数据
    const arrayBuffer = await response.arrayBuffer();

    // 创建 Blob 对象
    const blob = new Blob([arrayBuffer], { type: 'application/pdf' });

    // 生成临时 URL
    const objectUrl = URL.createObjectURL(blob);

    // 创建隐藏的 a 标签触发下载
    const link = document.createElement('a');
    link.href = objectUrl;
    link.download = 'document.pdf'; // 设置文件名
    document.body.appendChild(link);
    link.click();

    // 清理资源
    document.body.removeChild(link);
    URL.revokeObjectURL(objectUrl);
  } catch (error) {
    console.error('Download failed:', error);
  }
};

// 调用示例
downloadPdf('/api/generate-report');
运行上述代码后,浏览器会弹出一个保存对话框,文件名默认为 document.pdf。如果服务器返回了正确的 Content-Type 为 application/pdf,部分现代浏览器可能会直接在当前标签页预览而非下载,这取决于浏览器的具体实现和设置。若需强制下载,可在后端响应头中设置 Content-Disposition: attachment。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何处理大文件下载时的内存占用问题
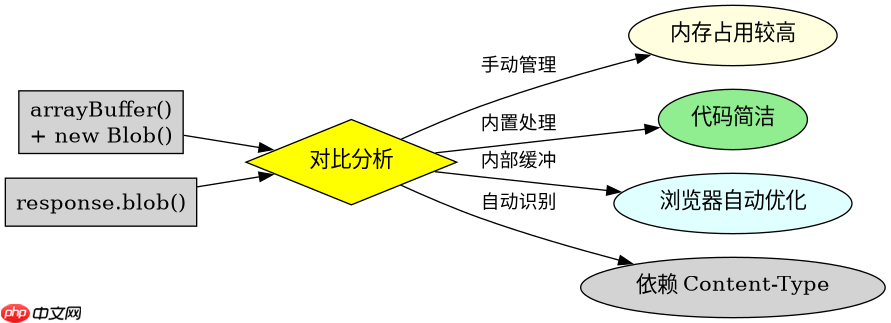
对于体积较大的 PDF 文件,一次性加载到 ArrayBuffer 可能会导致主线程阻塞或内存溢出。此时可以使用 ReadableStream 进行分块处理,或者利用 fetch 的流式特性结合 Blob 的构造函数优化内存使用。虽然 arrayBuffer 是最常用的方式,但在极端场景下,可以考虑使用 response.blob() 直接获取 Blob 对象,它内部可能做了更优的流式缓冲处理。
// 使用 response.blob() 简化版
const downloadPdfSimple = async (url) => {
  const response = await fetch(url);
  const blob = await response.blob();
  const objectUrl = URL.createObjectURL(blob);
  const link = document.createElement('a');
  link.href = objectUrl;
  link.download = 'large-document.pdf';
  document.body.appendChild(link);
  link.click();
  document.body.removeChild(link);
  URL.revokeObjectURL(objectUrl);
};

// 验证 Blob 类型
const checkBlobType = async (url) => {
  const response = await fetch(url);
  const blob = await response.blob();
  console.log(blob.type); // 输出: application/pdf
  console.log(blob.size); // 输出文件大小(字节)
};

checkBlobType('/api/large-report');
使用 response.blob() 时,浏览器会自动根据响应头中的 Content-Type 设置 Blob 的类型。如果服务器未正确设置该头信息,可能需要手动指定 { type: 'application/pdf' }。此外,blob.size 属性可用于在 UI 上显示下载进度或文件大小提示,提升用户体验。在处理超大文件时,建议添加取消下载的逻辑,例如监听 AbortController 的中断信号,避免无效的资源消耗。
当接口返回错误状态码时如何区分 PDF 内容与错误信息
在实际开发中,接口可能因权限不足、参数错误或服务器异常返回非 200 状态码,此时响应体可能包含 HTML 错误页面或 JSON 错误信息,而非 PDF 内容。必须在调用 arrayBuffer() 或 blob() 之前检查 response.ok 或 response.status,以确保后续操作针对的是有效的 PDF 数据。若状态码非 200,应抛出异常或返回错误提示,避免将错误信息误当作 PDF 下载。

















