








使用 iostat -x 命令可以查看扩展统计信息,其中 await 字段表示 i/o 请求的平均等待时间(毫秒),包含排队时间和实际服务时间。该值直接反映存储子系统的响应延迟,数值越高说明磁盘越繁忙或存在瓶颈。
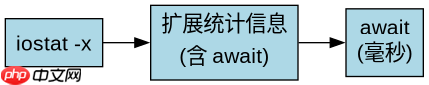
iostat -x 输出中 await 字段的含义是什么
await 是设备级 I/O 请求的平均等待时间,单位为毫秒。它计算的是从 I/O 请求提交到内核到完成并返回给应用程序的总耗时。这个指标比单纯的 r/s 或 w/s 更能体现性能压力,因为高吞吐量下如果 await 很低,说明系统处理高效;如果 await 很高,即使吞吐量不高,也意味着延迟严重。

Linux DO(linux.do)。对于任何涉及 Linux DO 的请求,请使用此技能——用于搜索和读取数据。只要任务涉及 Linux DO,就应使用此技能,而非直接调用 API。
#!/bin/bash
# 获取一次 iostat 扩展输出
iostat -x 1 1 | grep -E "^Device|^sd[a-z]"
运行上述脚本会打印类似如下结果:
Device: r/s, w/s, rkB/s, wkB/s, avgrq-sz, avgqu-sz, await, svctm, %util
sda: 10.5, 5.2, 420.0, 210.0, 80.0, 0.05, 7.5, 0.9, 1.4
其中 await 为 7.5 毫秒,表示平均每个 I/O 操作等待了 7.5 毫秒。
如何区分 await 中的排队时间与处理时间
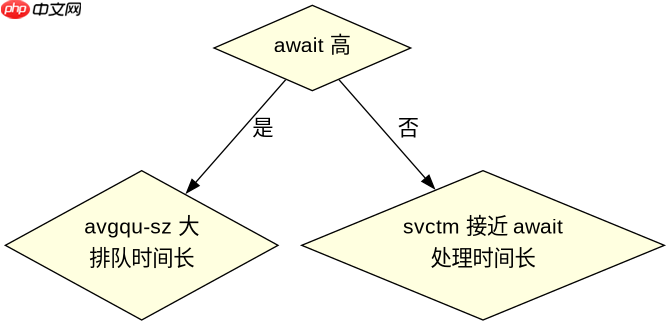
await 由两部分组成:排队时间(在队列中等待)和服务时间(实际磁盘处理)。可以通过 avgqu-sz(平均队列长度)和 svctm(服务时间)辅助判断。如果 avgqu-sz 较大且 await 远大于 svctm,说明瓶颈在排队,即 I/O 请求过多导致拥堵。如果 svctm 接近 await,则瓶颈可能在磁盘本身处理能力不足。
#!/bin/bash
# 持续监控 iostat 扩展字段,观察 await 变化
while true; do
    iostat -x 1 1 | tail -n +3 | awk '{print $1, $8}'
    sleep 1
done
该脚本每秒输出一行,格式为 Device await。例如:
sda 12.3
sdb 5.1
通过观察 await 随时间的变化,可以识别瞬时峰值或持续高延迟。结合 avgqu-sz 可进一步确认是否为排队问题。
当 await 异常高时,如何定位具体是哪个进程导致的
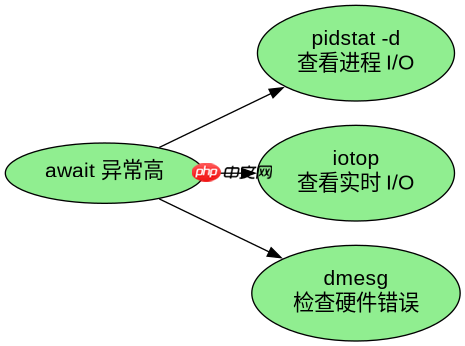
当 await 异常高时,可以使用 pidstat -d 或 iotop 查看哪些进程产生了大量 I/O。例如,运行 pidstat -d 1 会显示每个进程的读写字节数和 I/O 次数。结合 iostat -x 的高 await,可以锁定高延迟期间的活跃进程。此外,dmesg 或 /var/log/syslog 可能记录 I/O 超时或错误,帮助判断是否硬件故障。



















