








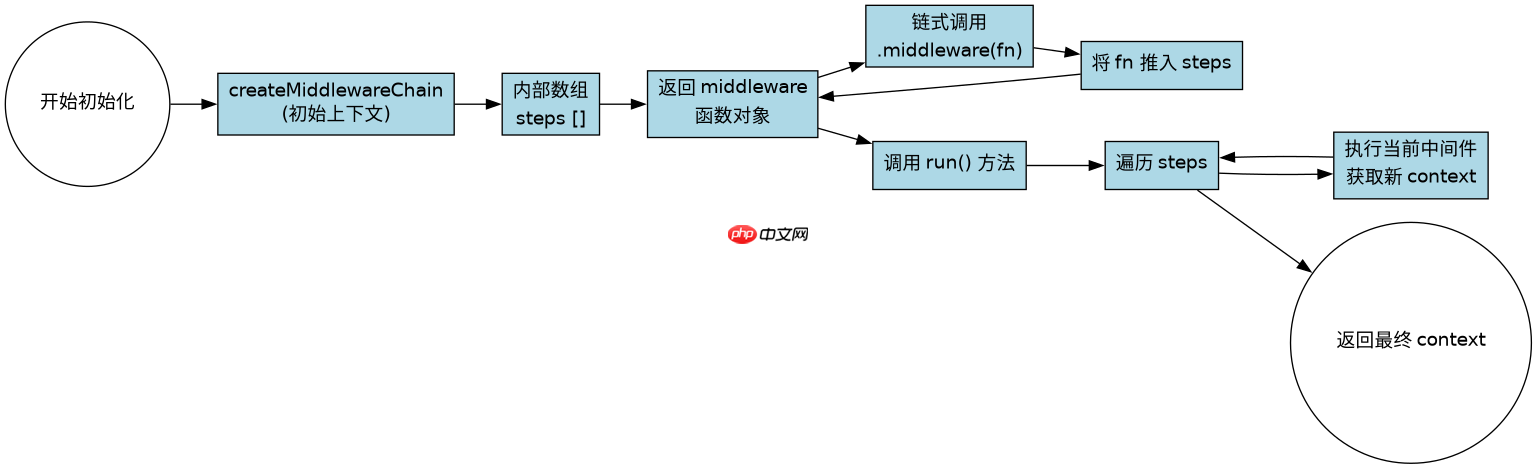
javascript 中实现函数柯里化中间件的核心做法是利用闭包保存状态,并通过返回新函数来串联处理逻辑。具体而言,定义一个高阶函数接收初始上下文或配置,内部维护一个处理链数组,每次调用返回的函数将新的处理步骤推入该数组并继续返回自身,最终通过一个 `run` 方法遍历执行。这样做的好处是能够以声明式的方式组装复杂的异步或同步任务流,且每个中间件只关注自己的职责。
如何设计支持链式调用的柯里化结构
要实现链式调用,关键在于让中间件工厂函数返回一个新的函数,这个新函数不仅执行当前逻辑,还负责接收下一个中间件或触发执行。我们通常使用一个数组来存储所有注册的中间件,并利用闭包保持这个数组的引用。当用户调用中间件时,实际上是向这个共享数组中添加一个处理单元,并返回当前的控制器实例以便继续链式调用。这种模式类似于 Express 的路由注册,但更侧重于数据流的转换而非 HTTP 请求。
function createMiddlewareChain(initialContext) {
  const steps = [];

  function middleware(fn) {
    if (typeof fn !== 'function') {
      throw new TypeError('Middleware must be a function');
    }
    steps.push(fn);
    return middleware; // 返回自身以支持链式调用
  }

  middleware.run = async function() {
    let context = { ...initialContext };
    for (const step of steps) {
      try {
        context = await step(context);
        if (!context || typeof context !== 'object') {
          throw new Error('Middleware must return a context object');
        }
      } catch (error) {
        console.error('Step failed:', error);
        break;
      }
    }
    return context;
  };

  return middleware;
}

// 使用示例
const chain = createMiddlewareChain({ data: [], user: null });

chain
  .then(ctx => ({ ...ctx, status: 'loading' }))
  .then(async ctx => {
    const res = await fetch('/api/data');
    return { ...ctx, data: await res.json(), status: 'loaded' };
  })
  .then(ctx => ({ ...ctx, processed: true }))
  .run()
  .then(console.log); // 输出最终上下文
上述代码定义了一个基础的中间件容器。注意,为了演示链式调用,我在示例中直接使用了 `.then` 语法,但这在原生 JS 中并不直接适用于普通函数对象,除非我们将其包装为 Promise 或自定义原型。更标准的做法是让 `middleware` 函数本身返回一个可链式调用的对象,或者像上面代码那样,`middleware` 是一个函数,但它有一个 `run` 属性。在实际的库如 Redux Saga 或 Koa 中,机制略有不同,但核心都是“收集-执行”分离。上面的例子展示了最朴素的柯里化形态:每次调用都返回同一个带有 `run` 方法的函数引用(如果我们在外部缓存)或者返回一个新的包装器。为了严格符合“柯里化”即部分应用参数的概念,我们可以将 `createMiddlewareChain` 视为一个工厂,它返回一个接受处理函数的函数。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何处理中间件间的参数传递与错误隔离
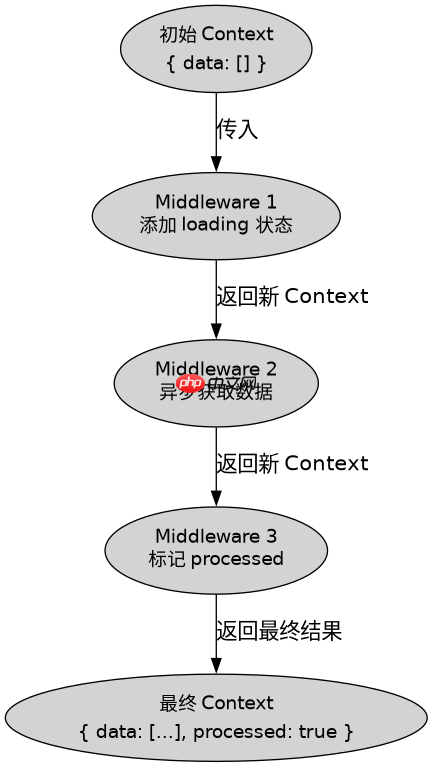
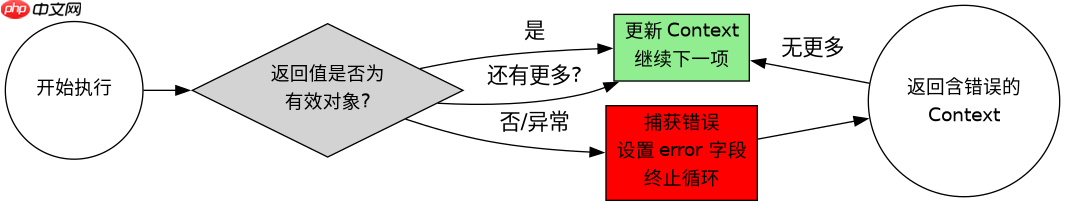
在中间件链条中,上下文对象(Context)是连接各个步骤的桥梁。每个中间件接收当前的 Context,处理后返回新的 Context。这种单向数据流确保了状态的不可变性和可预测性。对于错误处理,最佳实践是在每个中间件内部捕获异常,或者在全局的 `run` 循环中统一捕获。如果某个中间件失败,后续中间件不应再执行,且应保留错误信息供上层业务逻辑判断。此外,为了防止内存泄漏或状态污染,每次 `run` 都应基于初始上下文创建一个新的副本,而不是修改原始输入。
// 改进版:包含错误处理和更清晰的上下文传递
function curryMiddlewareFactory(initialCtx) {
  let handlers = [];

  const factory = (handler) => {
    if (typeof handler !== 'function') return factory;
    handlers.push(handler);
    return factory;
  };

  factory.execute = async () => {
    let currentCtx = JSON.parse(JSON.stringify(initialCtx)); // 深拷贝
    let errorOccurred = false;

    for (let i = 0; i < handlers.length; i++) {
      if (errorOccurred) break;
      try {
        const result = await handlers[i](currentCtx, nextHandlerIndex);
        if (result && result.error) {
          currentCtx.error = result.error;
          errorOccurred = true;
        } else {
          currentCtx = result || currentCtx;
        }
      } catch (e) {
        currentCtx.error = e;
        errorOccurred = true;
      }
    }
    return currentCtx;
  };

  return factory;
}

// 验证输入条件
const mw = curryMiddlewareFactory({ id: 1 });
mw((ctx) => ({ ...ctx, step1: true }));
mw((ctx) => { throw new Error('Test Error'); });

mw.execute().then(res => {
  console.log(res.error.message); // 输出: Test Error
  console.log(res.step1);         // 输出: true
});
在这个改进版本中,我们引入了 `nextHandlerIndex` 的概念(虽然在本例中未直接使用,但在某些高级中间件中用于跳过步骤),并增强了错误处理机制。如果中间件显式返回 `{ error: ... }` 或抛出异常,流程会中断并记录错误。这确保了即使发生错误,之前的处理结果(如 `step1: true`)依然保留在上下文中,便于调试和恢复。这种设计使得中间件既独立又协作,符合单一职责原则。
当中间件返回非对象值时会发生什么
如果在中间件实现中,某个步骤返回了非对象类型的值(例如字符串、数字或 undefined),后续的中间件在尝试解构或访问其属性时将导致运行时错误。在我们的 `createMiddlewareChain` 实现中,我们在 `run` 方法里加入了一个类型检查:`if (!context || typeof context !== 'object')`。一旦检测到非法返回值,系统会立即抛出错误并终止后续中间件的执行。这一机制保证了数据流的完整性,防止因类型不匹配导致的隐蔽 Bug。开发者必须确保每个中间件要么返回完整的上下文对象,要么返回 `undefined`/`null` 时明确处理终止逻辑,但在本设计中,我们强制要求返回对象以维持链路的连贯性。

















