








在 javascript 的异步函数中,将 await 与记忆化(memoization)结合使用的核心在于:必须确保对同一个输入参数的并发调用共享同一个 promise 实例。如果直接缓存普通值,会导致重复执行异步逻辑;如果缓存逻辑不当,还会引发竞态条件。正确的做法是使用一个 map 或对象来存储“输入参数 -> promise”的映射关系,并在获取缓存时直接返回该 promise,从而让多个调用者同步等待同一个异步结果。
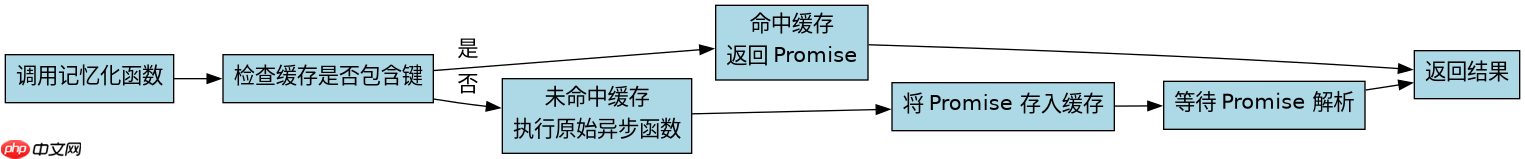
如何构建支持异步操作的基础记忆化包装器
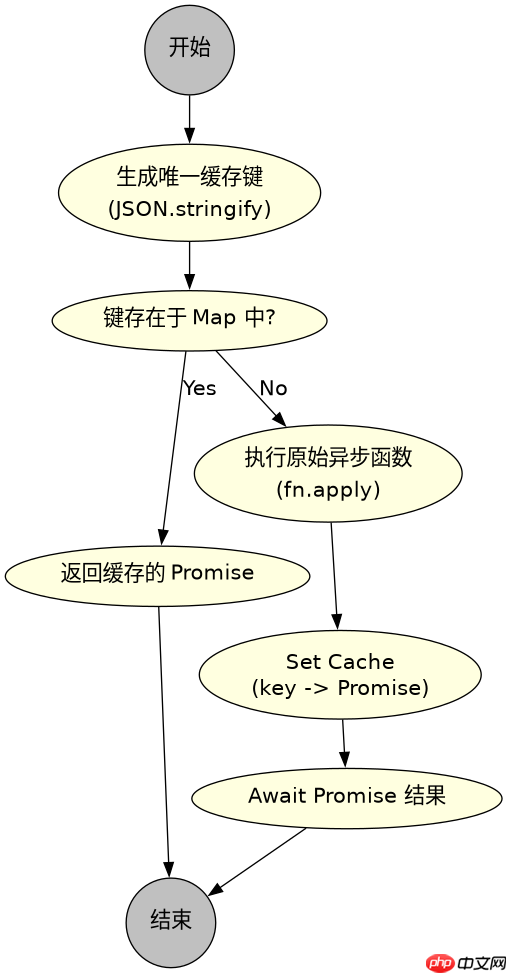
要实现一个通用的异步记忆化函数,需要创建一个闭包环境来维护缓存状态。这个包装器接收一个原始异步函数作为参数,并返回一个新的代理函数。当新函数被调用时,它首先检查缓存中是否存在对应的键。如果存在,直接返回缓存中的 Promise;如果不存在,则执行原始函数,捕获其返回的 Promise 并将其存入缓存后返回。这种模式确保了即使原始函数是异步的,记忆化机制也能正确工作,因为 Promise 本身是可缓存且可复用的。
function asyncMemoize(fn) {
  const cache = new Map();

  return async function(...args) {
    // 生成唯一的缓存键
    const key = JSON.stringify(args);

    if (cache.has(key)) {
      console.log('Cache hit for:', key);
      return cache.get(key);
    }

    console.log('Cache miss, executing fn for:', key);
    // 执行原始异步函数
    const promise = fn.apply(this, args);

    // 关键步骤:将 Promise 存入缓存
    cache.set(key, promise);

    // 等待结果并返回
    return await promise;
  };
}
上述代码展示了最基础的实现。这里使用了 JSON.stringify(args) 来生成缓存键,适用于简单的参数类型。在实际生产环境中,可能需要更复杂的键生成策略来处理对象或函数参数。重要的是,cache.set(key, promise) 这一行必须在 fn 被调用后立即执行,而不是等待 await 完成之后。这样,其他并发调用者才能在等待期间获取到同一个 Promise 引用。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何处理并发调用与缓存清理策略
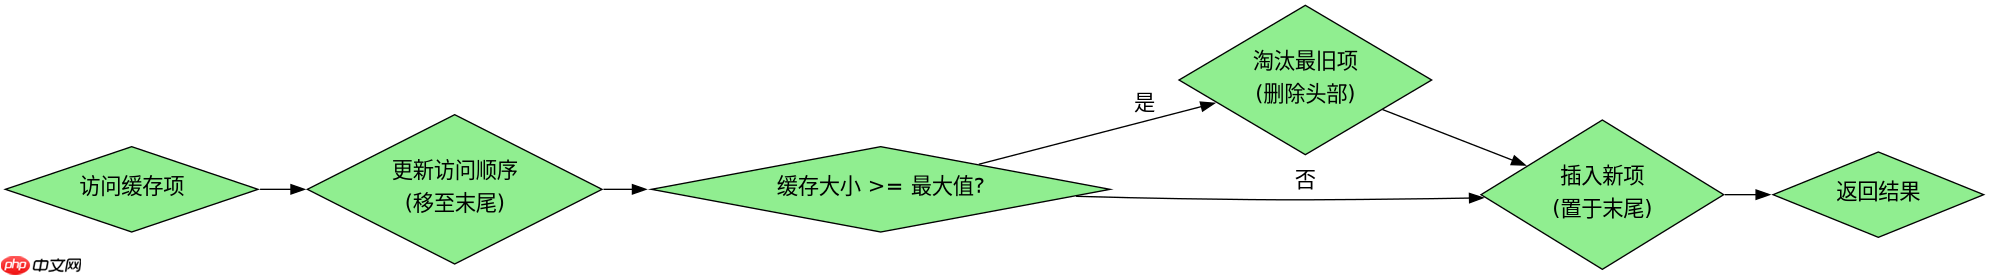
在处理高并发场景时,仅仅缓存 Promise 还不够,还需要考虑缓存的大小限制和清理策略。如果不加控制,缓存会无限增长,导致内存泄漏。常见的策略包括使用 LRU(最近最少使用)算法或设置最大容量。此外,对于异步操作,还需要注意错误处理。如果原始函数抛出异常,该异常会被封装在 Promise 的 rejection 中。如果我们将 rejected Promise 也存入缓存,后续相同的调用也会立即失败。因此,通常的做法是只在成功时缓存,或者在缓存中区分成功和失败的状态。
class AsyncLRUMemoizer {
  constructor(maxSize = 100) {
    this.cache = new Map();
    this.maxSize = maxSize;
  }

  wrap(fn) {
    return async (...args) => {
      const key = JSON.stringify(args);

      if (this.cache.has(key)) {
        // 更新访问顺序,移到末尾
        const value = this.cache.get(key);
        this.cache.delete(key);
        this.cache.set(key, value);
        return value;
      }

      try {
        const result = await fn(...args);

        // 如果缓存已满,移除最旧的项
        if (this.cache.size >= this.maxSize) {
          const firstKey = this.cache.keys().next().value;
          this.cache.delete(firstKey);
        }

        this.cache.set(key, result);
        return result;
      } catch (error) {
        // 可选:不缓存错误,或者缓存错误但标记为过期
        throw error;
      }
    };
  }
}

// 使用示例
const fetchData = async (id) => {
  console.log(`Fetching data for ID: ${id}`);
  return new Promise(resolve => setTimeout(() => resolve({ id, data: 'some data' }), 1000));
};

const memoizedFetch = new AsyncLRUMemoizer(5).wrap(fetchData);

memoizedFetch(1).then(console.log);
memoizedFetch(1).then(console.log); // 命中缓存
memoizedFetch(2).then(console.log); // 未命中
这段代码展示了一个带有 LRU 淘汰策略的异步记忆化类。它通过 Map 的自然插入顺序来实现 LRU,每次访问时将元素移到末尾。在缓存满时,删除第一个元素。这种实现方式不仅解决了并发问题,还引入了资源管理,防止内存溢出。需要注意的是,这里的 try...catch 块中没有缓存错误,这意味着如果请求失败,下次相同参数的请求会重新发起。如果需要缓存错误,可以在 catch 块中将错误对象存入缓存,并在读取时判断是否为错误实例。
基于特定输入参数冲突的具体问题分析
在使用 JSON.stringify 作为缓存键时,一个常见的问题是对象属性的顺序不一致导致的键冲突。例如,{a: 1, b: 2} 和 {b: 2, a: 1} 在 JSON 序列化后可能产生不同的字符串,尽管它们代表相同的逻辑对象。这会导致本应命中的缓存失效,造成不必要的重复计算。为了解决这个问题,可以使用更健壮的键生成方法,如递归排序对象键或使用专门的序列化库。
function stableStringify(obj) {
  if (obj === null || typeof obj !== 'object') {
    return String(obj);
  }
  if (Array.isArray(obj)) {
    return '[' + obj.map(stableStringify).join(',') + ']';
  }
  const keys = Object.keys(obj).sort();
  return '{' + keys.map(k => `"${k}":${stableStringify(obj[k])}`).join(',') + '}';
}

// 替换原有的 JSON.stringify
const key = stableStringify(args[0]);
通过引入 stableStringify 函数,我们可以确保无论对象属性的原始顺序如何,生成的缓存键都是一致的。这对于处理复杂数据结构作为参数的异步函数至关重要。在实际应用中,还可以考虑使用 structuredClone 或第三方库如 fast-json-stable-stringify 来提高性能和可靠性。总之,选择合适的缓存键生成策略是确保异步记忆化正确性的关键一环。

















