避免 linux cron 定时任务资源冲突的核心做法是引入互斥锁机制,确保同一时间只有一个实例在运行。推荐使用 flock 命令将脚本包裹起来,利用文件锁的原子性来拦截并发执行;或者在脚本内部使用 pidof 或 pgrep 检查进程是否存在。这样当上一个任务尚未结束时,新的 cron 触发点会被直接跳过,从而防止 cpu、内存或磁盘 i/o 等资源被重复占用导致系统过载。
cron 调用脚本时如何配置 flock 参数
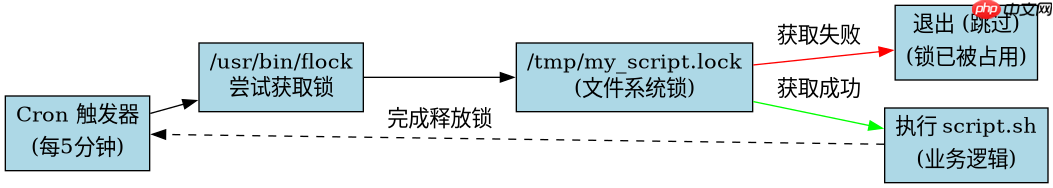
在 crontab 中直接使用 flock 是最简单的方案,无需修改脚本内部逻辑。你需要指定一个锁文件路径(通常放在 /tmp 或 /var/lock),并设置超时时间以防止死锁。如果前一次执行还在运行,flock 会立即返回非零状态码,cron 便不会启动新进程。
*/5 * * * * /usr/bin/flock -w 300 /tmp/my_script.lock /path/to/script.sh
上述命令中,-w 300 表示等待锁释放的最长时间为 300 秒。如果超过这个时间锁仍未释放,flock 会放弃获取锁并退出,这避免了无限期挂起。锁文件本身不需要预先创建,flock 会自动处理。这种方式的优点是脚本内容保持纯净,任何语言编写的脚本都可以被包裹执行。
脚本内部如何实现自检测查
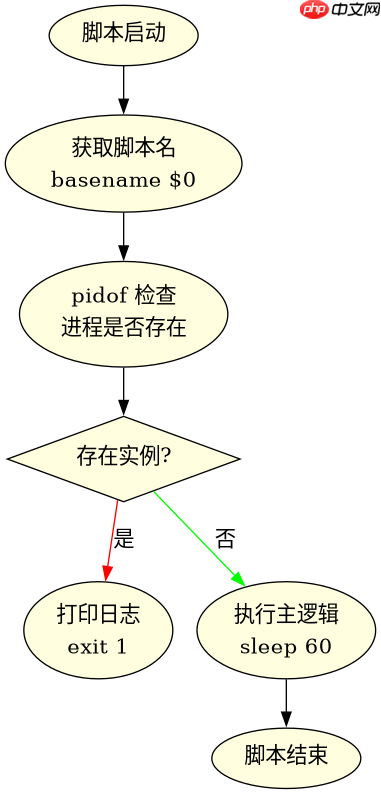
对于需要更精细控制的场景,可以在脚本开头加入进程检查逻辑。这种方法不依赖外部命令包裹,而是通过判断当前系统中是否已存在同名进程来决定是否继续执行。这种方式适合那些需要记录详细日志或在特定条件下才允许并发的复杂脚本。

#!/bin/bash
SCRIPT_NAME=$(basename $0)
if pidof $SCRIPT_NAME > /dev/null; then
    echo "Another instance is running, exiting."
    exit 1
fi
# 业务逻辑开始...
echo "Running main logic..."
sleep 60
这段代码首先获取脚本名称,然后使用 pidof 搜索正在运行的同名进程。如果找到,说明已有实例在运行,脚本直接退出并返回错误码 1。如果没有找到,则继续执行后续的业务逻辑。需要注意的是,pidof 可能会匹配到部分进程名,因此在生产环境中建议使用更精确的 PID 文件管理或 pgrep -x 进行完全匹配。
高负载下 flock 与 pidof 的性能差异
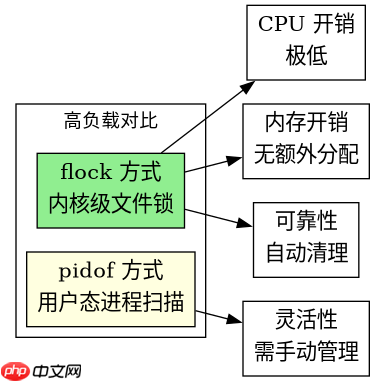
在系统负载极高或 Cron 堆积严重时,两种方法的资源消耗表现不同。flock 基于内核的文件锁机制,开销极小,几乎不占用 CPU 周期,仅涉及少量的系统调用。而 pidof 或 pgrep 需要遍历进程表,当系统进程数量巨大时,这会带来一定的 CPU 和内存开销。此外,flock 能够处理信号中断等异常情况下的锁释放,而手动管理的 PID 文件若未正确清理,可能导致“假死”锁,需要额外的清理逻辑。