








javascript 闭包捕获的是变量在内存中的引用而非快照,因此当循环使用 let 声明块级作用域变量时,每次迭代都会创建新的绑定,闭包能正确捕获当前迭代的值。优化内存的关键在于理解这种“每轮新绑定”的机制,避免在不需要保留引用的场景下让闭包持有过大的对象或数组。
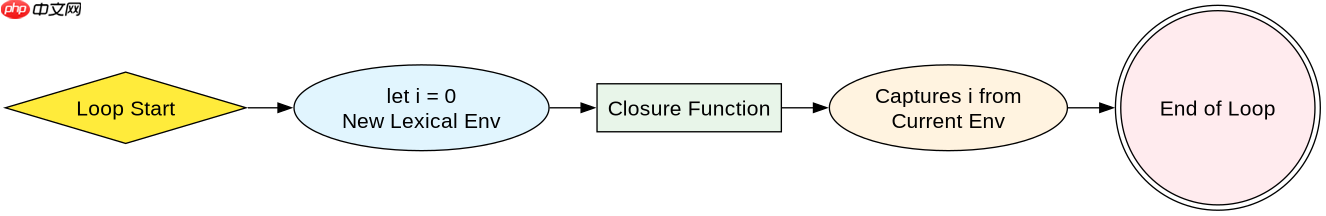
为什么 let 能解决闭包捕获旧值的问题
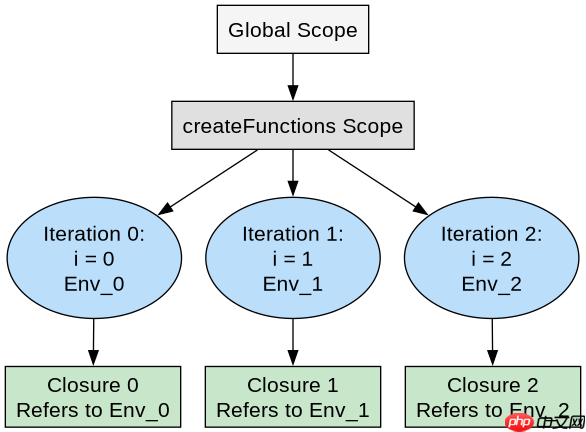
使用 let 声明循环变量时,JavaScript 引擎会在每次循环迭代中创建一个新的词法环境(Lexical Environment),并将变量绑定到这个新环境中。这意味着每个闭包都指向自己独立的那一轮变量副本,从而避免了所有闭包共享同一个变量的问题。相比之下,如果使用 var,所有闭包都会共享同一个全局或函数级的变量,导致捕获到的是最终更新后的值。
function createFunctions() {
    const funcs = [];
    for (let i = 0; i < 3; i++) {
        funcs.push(function() {
            console.log(i);
        });
    }
    return funcs;
}

const myFuncs = createFunctions();
myFuncs[0](); // 输出 0
myFuncs[1](); // 输出 1
myFuncs[2](); // 输出 2
上述代码展示了 let 如何确保每个闭包捕获正确的 i 值。每个函数在创建时,其内部的词法环境都绑定到了当时独立的 i 变量上。当函数被调用时,它们访问的是各自绑定的那个 i,而不是最后循环结束时的 i 值。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
使用 IIFE 模拟块级作用域的行为
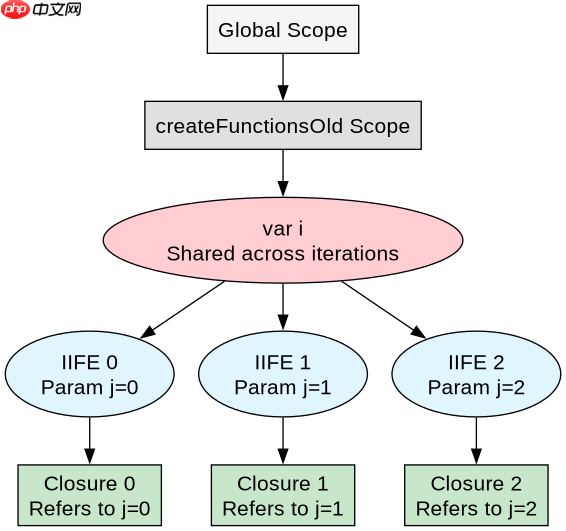
在 ES6 之前,开发者通常使用立即执行函数表达式(IIFE)来模拟块级作用域,以解决闭包捕获变量值的问题。IIFE 为每次迭代创建一个新的作用域,使得闭包能够捕获当前迭代的变量值。虽然现代 JavaScript 推荐使用 let,但了解 IIFE 的工作原理有助于深入理解闭包的内存模型。
function createFunctionsOld() {
    const funcs = [];
    for (var i = 0; i < 3; i++) {
        funcs.push((function(j) {
            return function() {
                console.log(j);
            };
        })(i));
    }
    return funcs;
}

const myFuncsOld = createFunctionsOld();
myFuncsOld[0](); // 输出 0
myFuncsOld[1](); // 输出 1
myFuncsOld[2](); // 输出 2
在这个例子中,IIFE 接收当前的 i 值作为参数 j,并返回一个闭包。这个闭包捕获的是 j,而 j 是每次迭代时传入的独立值。这种方式与 let 的效果相同,但代码更为冗长。在现代开发中,除非需要兼容非常旧的浏览器,否则应优先使用 let。
闭包持有大对象时的内存泄漏风险
当闭包捕获了大型对象或数组时,即使这些对象在后续逻辑中不再需要,只要闭包存在,这些对象就无法被垃圾回收。这可能导致内存占用过高,尤其是在长时间运行的应用中。为了优化内存,应避免在闭包中捕获不必要的大对象,或者在使用完毕后手动将引用设置为 null,以便垃圾回收器能够释放内存。
function processLargeData(data) {
    const processedData = data.map(item => item * 2);

    // 闭包捕获了 processedData
    const result = function() {
        return processedData.reduce((sum, val) => sum + val, 0);
    };

    // 如果不再需要 processedData,可以将其置空
    // processedData = null; // 注意:这里不能直接置空,因为闭包仍引用它

    return result;
}

// 更好的做法:只捕获需要的部分
function processLargeDataOptimized(data) {
    const sum = data.reduce((acc, item) => acc + item * 2, 0);

    return function() {
        return sum;
    };
}
在第一个示例中,闭包捕获了整个 processedData 数组,即使只需要求和结果。这会导致整个数组驻留在内存中。而在优化后的版本中,我们只捕获了计算出的总和 sum,这是一个简单的数值,占用的内存远小于整个数组。这种做法显著减少了内存占用,特别是在处理大数据集时。


















