








在sql中利用cube函数生成全交叉报表,核心在于将group by子句中的列组合替换为cube(列1, 列2, ...)。该操作会自动计算所有可能的维度组合(包括总计行),并返回包含原始明细、小计和总计的完整数据集。通过结合rollup或单独使用cube,可以一次性获得多维度的聚合结果,避免编写多个union all查询。
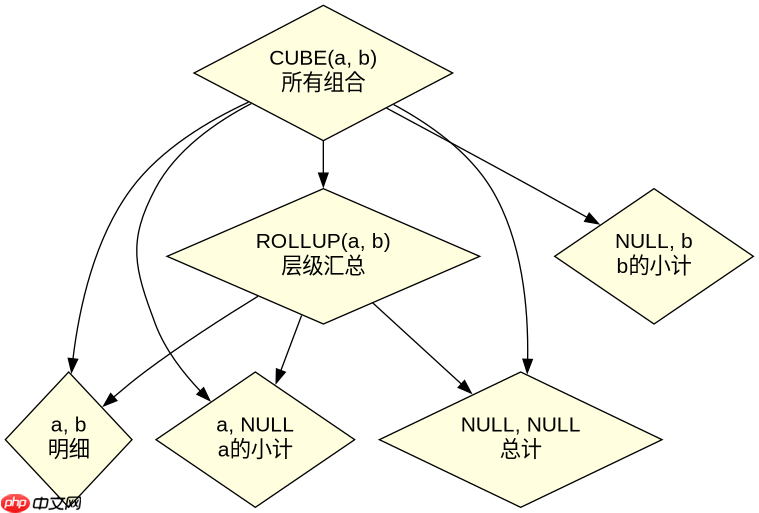
CUBE与ROLLUP在聚合层级上的区别是什么
CUBE生成所有可能的列组合,而ROLLUP仅生成从左到右的层级汇总。若需全交叉报表应选CUBE,若只需固定层级(如年-月)则选ROLLUP。
SELECT
    category,
    region,
    SUM(sales) AS total_sales
FROM sales_data
GROUP BY CUBE(category, region);
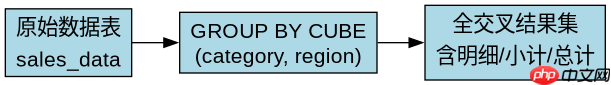
上述代码对category和region进行全排列分组。结果包含:(A, East), (A, West), (B, East)... 以及各category的小计、各region的小计,以及最终总计行。空值表示该维度被忽略。
如何区分CUBE生成的不同汇总级别
使用GROUPING()函数判断某列是否为NULL是由于CUBE产生的汇总标记。当GROUPING(col)=1时,表示该列在当前行中被聚合掉了。
SELECT
    COALESCE(category, 'All Categories') AS category,
    COALESCE(region, 'All Regions') AS region,
    SUM(sales) AS total_sales,
    GROUPING(category) AS grp_cat,
    GROUPING(region) AS grp_reg
FROM sales_data
GROUP BY CUBE(category, region);
运行后,'All Categories'行对应grp_cat=1且grp_reg=0(按region汇总)或两者均为1(总计)。这允许在应用层或SQL层精确识别汇总类型。
基于GROUPING_ID函数的具体应用问题
GROUPING_ID()接受多列作为参数,返回一个整数位掩码,用于唯一标识每一行的汇总级别。例如GROUPING_ID(category, region)在(category=NULL, region=NULL)时返回3(二进制11),在(category='A', region=NULL)时返回2(二进制10)。
SELECT
    category,
    region,
    SUM(sales) AS total_sales,
    GROUPING_ID(category, region) AS level_id
FROM sales_data
GROUP BY CUBE(category, region)
ORDER BY level_id;
此查询按level_id排序,清晰展示从明细(level_id=0)到单维汇总(level_id=1,2)再到总汇总(level_id=3)的结构。开发者可利用level_id进行条件过滤或标签映射,无需处理复杂的COALESCE逻辑。


















