








在sql中利用子查询避免group by出现非聚合列的核心做法是:先通过子查询或cte将需要分组的维度与聚合结果合并,再在外层查询中对这些预计算好的值进行最终筛选或展示。具体而言,可以使用窗口函数配合子查询,或者使用having子句结合相关子查询来过滤组,从而避免在select列表中包含未聚合且不在group by中的列。这样做能确保sql语句符合标准语法,同时获得预期的业务数据。

如何使用窗口函数解决非聚合列显示问题
当需要在保留分组聚合结果的同时显示行级详细信息时,窗口函数是最直接的解决方案。它允许在不改变GROUP BY语义的情况下,将聚合值附加到每一行上。例如,要找出每个部门工资最高的员工姓名和工资,传统GROUP BY只能返回部门和最高工资,无法直接返回姓名。通过子查询包裹窗口函数计算结果,外层只需对聚合后的数据进行简单选择,即可避开非聚合列报错。
WITH RankedSalaries AS (
    SELECT
        department_id,
        employee_name,
        salary,
        ROW_NUMBER() OVER(PARTITION BY department_id ORDER BY salary DESC) as rn
    FROM employees
)
SELECT
    department_id,
    employee_name,
    salary
FROM RankedSalaries
WHERE rn = 1;
上述代码首先构建了一个CTE(公共表表达式),其中使用了ROW_NUMBER()窗口函数。该函数按department_id分区,并按salary降序排列,为每个部门的员工分配排名。外层查询直接从CTE中选择排名为1的记录,即每个部门工资最高的员工。这种方法避免了在GROUP BY中强制包含employee_name,因为employee_name在CTE中已经是确定的行级数据,外层查询仅做过滤,不涉及聚合逻辑冲突。
如何通过HAVING子句结合子查询过滤特定组
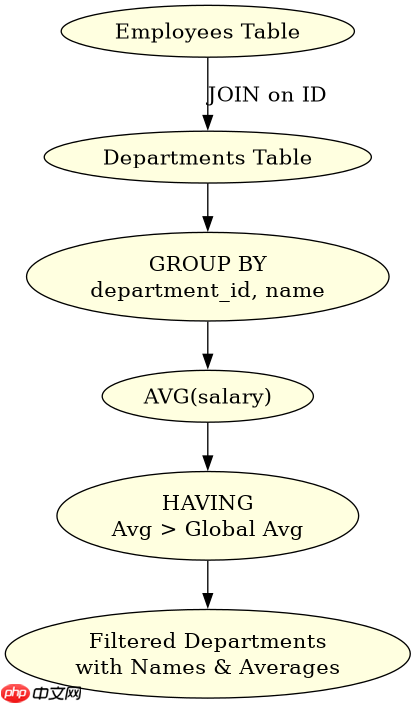
如果目标是筛选出满足特定聚合条件的组,并在结果中展示组的某些非聚合属性,可以使用HAVING子句配合相关子查询。这种方法适用于需要基于组内统计量来决定是否保留该组的情况。例如,查找平均薪资高于公司总平均薪资的部门及其名称。虽然部门名称是非聚合列,但可以通过子查询先计算出符合条件的部门ID,再关联获取名称,从而规避GROUP BY限制。
SELECT
    e.department_id,
    d.department_name,
    AVG(e.salary) as avg_salary
FROM employees e
JOIN departments d ON e.department_id = d.department_id
GROUP BY e.department_id, d.department_name
HAVING AVG(e.salary) > (
    SELECT AVG(salary) FROM employees
);
在这个例子中,GROUP BY包含了department_id和department_name。这看似违反了“非聚合列必须在GROUP BY中”的规则,但实际上,由于department_id和department_name之间存在函数依赖(一个ID对应唯一名称),许多现代SQL引擎(如MySQL 5.7+开启ONLY_FULL_GROUP_BY后)允许这种写法,前提是保证唯一性。然而,为了严格遵循标准并避免兼容性问题,更稳妥的做法是使用子查询先筛选出高平均薪资的部门ID,再关联查询名称。若必须在一个查询中完成且引擎不支持函数依赖推断,则应使用子查询预筛选ID:
SELECT
    e.department_id,
    d.department_name,
    AVG(e.salary) as avg_salary
FROM employees e
JOIN departments d ON e.department_id = d.department_id
WHERE e.department_id IN (
    SELECT department_id
    FROM employees
    GROUP BY department_id
    HAVING AVG(salary) > (SELECT AVG(salary) FROM employees)
)
GROUP BY e.department_id, d.department_name;
此版本先在内层子查询中找出平均薪资超过全局平均的部门ID集合,外层查询仅对这些ID对应的员工进行分组聚合。这样,department_name虽然出现在SELECT和GROUP BY中,但其值由已筛选出的department_id唯一确定,逻辑清晰且符合所有SQL标准的严格模式。关键在于,非聚合列department_name之所以能安全存在,是因为它被限制在了由聚合条件预先定义的、具有唯一性的组内。
当子查询返回多行时如何处理主键冲突
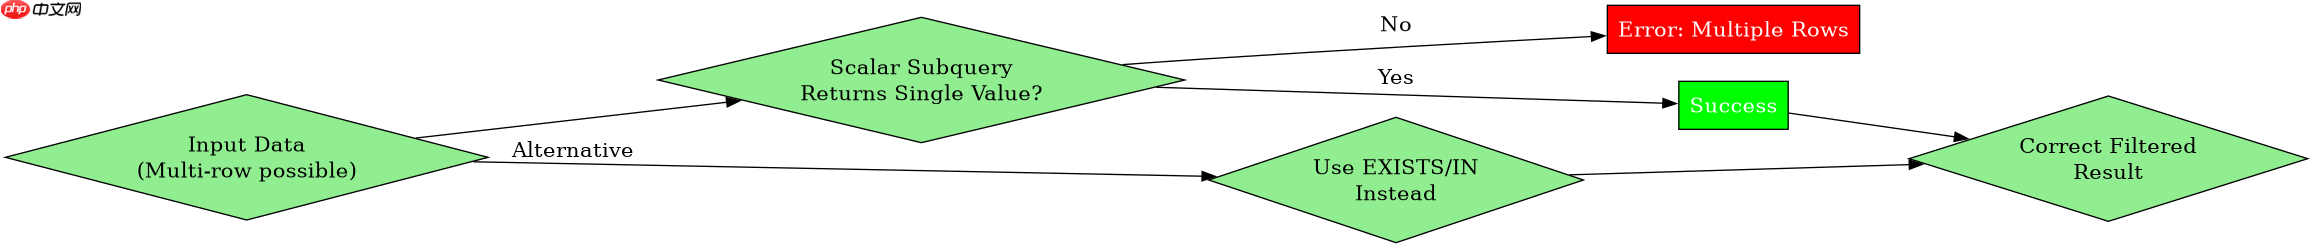
在使用子查询进行数据过滤或关联时,如果子查询返回了多行数据而外层期望单值,会导致执行错误。例如,在尝试用标量子查询比较某个员工的薪资与其所在部门的平均薪资时,若部门ID传递错误导致子查询匹配多个部门,就会引发“子查询返回超过一行”的错误。解决此问题的关键是确保子查询的WHERE条件足够精确,或使用IN/EXISTS代替标量比较。
-- 错误示例:假设dept_id可能对应多个记录或子查询逻辑有误
SELECT employee_name, salary
FROM employees
WHERE salary > (
    SELECT AVG(salary)
    FROM employees
    WHERE department_id = 10 -- 固定ID,通常安全,但若动态传入需小心
);

-- 更安全的方式:使用JOIN或EXISTS处理潜在的多对多关系
SELECT e.employee_name, e.salary
FROM employees e
WHERE EXISTS (
    SELECT 1
    FROM departments d
    WHERE d.department_id = e.department_id
    AND d.avg_salary_threshold > e.salary
);
在上述代码中,第一个查询是安全的,因为department_id=10是常量。但在实际应用中,如果子查询依赖于外部变量且该变量可能导致多行结果,应改用EXISTS或IN。EXISTS检查是否存在满足条件的行,不关心返回多少列,只关心布尔结果,因此能有效避免因多行返回导致的类型错误。这种方法特别适用于需要根据复杂条件动态过滤主表数据的场景,确保了查询的健壮性。


















