








在sql中利用嵌套子查询找出前10%的高频客户,核心做法是先通过子查询计算出所有客户的订单总数并排序,再根据总行数计算10%的阈值,最后在外层查询中筛选出订单数大于等于该阈值的客户。具体实现时,通常使用窗口函数 rank() 或 dense_rank() 结合 count(*) 来生成排名和百分比,或者使用相关子查询逐行比较。这样做可以直接得到高频客户列表,无需预先知道具体的数量界限。

如何使用窗口函数配合子查询计算客户排名百分比
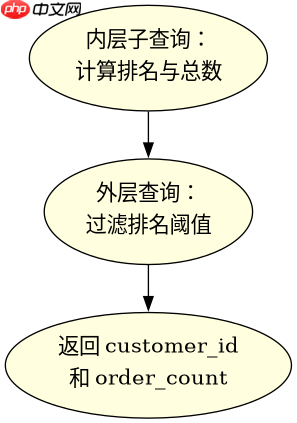
使用窗口函数 RANK() 配合子查询是处理此类问题的标准方法。首先在内层子查询中按客户分组统计订单量,并使用 RANK() OVER (ORDER BY order_count DESC) 获取排名,同时用 COUNT(*) OVER () 获取总记录数。外层查询则直接过滤排名小于等于总记录数乘以0.1的行。这种方法逻辑清晰,能准确处理并列排名的情况。
SELECT customer_id, order_count
FROM (
    SELECT
        customer_id,
        COUNT(order_id) AS order_count,
        RANK() OVER (ORDER BY COUNT(order_id) DESC) as rnk,
        COUNT(*) OVER () as total_customers
    FROM orders
    GROUP BY customer_id
) ranked_customers
WHERE rnk <= total_customers * 0.1;
上述代码假设存在一个名为 orders 的表,包含 customer_id 和 order_id 字段。运行结果将返回订单数最多的前10%的客户ID及其订单总数。如果总客户数为100,则返回排名前10的客户;若存在并列第10名,则可能返回多于10条记录。
如何在不支持窗口函数的旧版SQL中使用相关子查询
对于不支持窗口函数的旧版数据库(如MySQL 5.7及以下),可以使用相关子查询来实现相同的目标。内层子查询计算当前客户之外的其他客户中,订单数大于等于当前客户订单数的数量。如果这个数量加上1(即当前客户自己)小于等于总客户数的10%,则该客户属于高频客户。这种方法虽然性能较低,但兼容性最好。

SELECT o1.customer_id, COUNT(o1.order_id) AS order_count
FROM orders o1
GROUP BY o1.customer_id
HAVING 1 + (
    SELECT COUNT(DISTINCT o2.customer_id)
    FROM orders o2
    WHERE (SELECT COUNT(*) FROM orders WHERE customer_id = o2.customer_id) >= (SELECT COUNT(*) FROM orders WHERE customer_id = o1.customer_id)
) <= (SELECT COUNT(DISTINCT customer_id) FROM orders) * 0.1;
这段代码通过自关联和聚合操作,逐行判断每个客户是否处于前10%。它先统计每个客户的订单数,然后在HAVING子句中通过子查询计算有多少个客户的订单数不低于当前客户。最终筛选出满足比例条件的客户。注意,这种写法在数据量大时效率极低,仅适用于小规模数据或兼容性问题场景。
当总客户数不足10人时前10%的计算结果如何处理
基于上述程序,当总客户数较少(例如只有5个客户)时,前10%的计算结果为0.5。由于排名必须是整数,SQL中的比较运算会将阈值向下取整或按实际数值比较。在窗口函数方案中,rnk 意味着只有排名第1的客户可能被选中(如果排名从1开始且严格大于0.5则无结果,取决于具体实现)。实际上,大多数数据库会返回至少一名客户,因为排名1通常小于等于0.5的情况不会发生,但若使用 <code>CEIL() 或 FLOOR() 调整阈值,行为会有所不同。默认情况下,若阈值为0.5,排名第1的客户(rnk=1)不满足 1 ,因此可能返回空集。为确保至少返回一名客户,通常建议对阈值进行向上取整处理,即 <code>rnk 。


















