








如何通过视图统一历史冷数据与热数据的查询接口
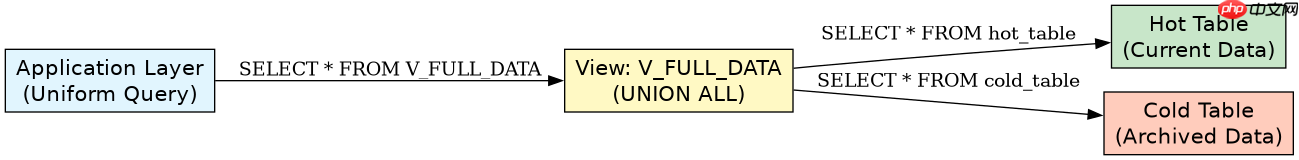
通过创建一张包含 union all 的视图,将当前活跃的热数据表与归档的冷数据表合并,即可对外提供统一的查询接口。具体做法是定义一个 v_full_data 视图,内部使用 select * from hot_table union all select * from cold_table 进行拼接。这样做的好处是应用层无需感知数据分布,直接查询该视图即可获得完整数据集,同时保留了底层分表的结构。
如何确保冷热数据在视图中正确关联且无重复
在构建视图时,必须确保热表和冷表的数据结构完全一致,并且通过时间戳或主键范围严格区分两者,避免数据重叠。通常的做法是在视图中增加一列标识数据来源(如 data_source_type),并在查询时利用索引优化性能。如果两张表存在相同的主键,说明数据迁移不彻底,需要清理热表中已归档的记录,保证 UNION ALL 的结果集唯一性。
当查询条件仅针对热数据时,视图是否会扫描冷数据
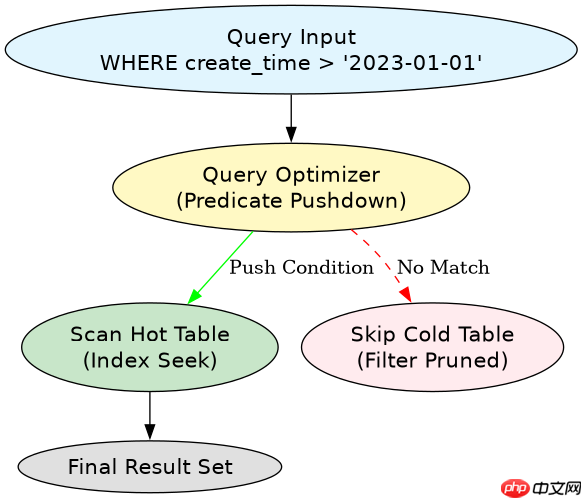
这取决于数据库的查询优化器是否支持谓词下推(Predicate Pushdown)。在现代关系型数据库(如 MySQL 8.0+、PostgreSQL)中,如果查询条件明确指向热表特有的字段(如 create_time > '2023-01-01'),优化器通常会将过滤条件下推到子查询中,从而跳过对冷表的扫描。但如果查询条件模糊或涉及全表聚合,优化器可能无法剪枝,导致冷数据也被读取,此时建议直接使用热表查询以提升性能。

















