








如何避免多表关联时的笛卡尔积
在sql中防止多表关联产生笛卡尔积的核心方法是使用显式的`join`语法并严格指定`on`连接条件。当涉及多表时,必须确保每一对参与连接的表之间都有明确的匹配键(如主外键关系),否则数据库引擎无法确定行之间的对应关系,从而生成所有行的组合。通过为每个`join`子句提供唯一的过滤谓词,可以精确控制数据的合并逻辑,消除不必要的交叉乘积。

SELECT t1.id, t1.name, t2.value, t3.category
FROM table1 t1
INNER JOIN table2 t2 ON t1.id = t2.t1_id
INNER JOIN table3 t3 ON t2.id = t3.t2_id;
上述代码展示了标准的三表连接方式。`table1`与`table2`通过`t1.id`和`t2.t1_id`关联,`table2`与`table3`通过`t2.id`和`t3.t2_id`关联。这种链式连接确保了每一行都经过两次过滤,最终结果集仅包含符合所有关联条件的记录,彻底避免了笛卡尔积。
如何在多表关联后实现多粒度聚合
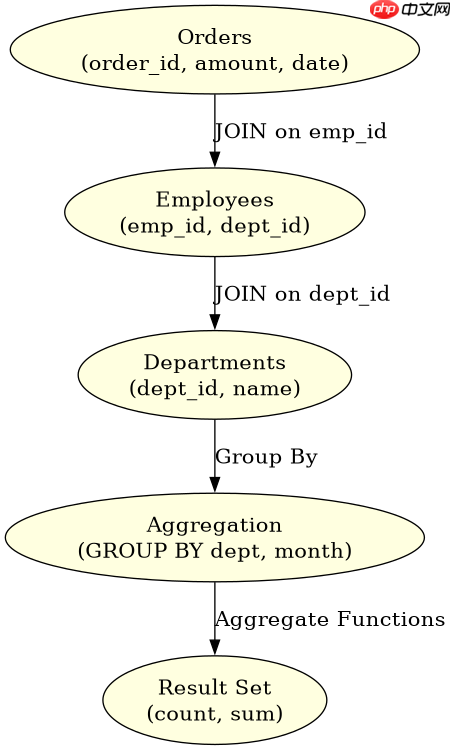
在多表关联完成后进行多粒度聚合,关键在于使用`GROUP BY`子句结合多个聚合函数。通常的做法是先完成所有必要的表连接,然后在最终的查询层面对所需的维度列进行分组。例如,如果需要根据“部门”和“月份”两个粒度统计销售额,只需在`GROUP BY`中同时列出这两个字段即可。这种方法允许在同一查询结果中返回不同层级的汇总数据,前提是这些维度在关联后的表中是独立存在的。
SELECT
    d.department_name,
    DATE_FORMAT(o.order_date, '%Y-%m') as month,
    COUNT(*) as order_count,
    SUM(o.amount) as total_sales
FROM orders o
JOIN employees e ON o.employee_id = e.id
JOIN departments d ON e.department_id = d.id
GROUP BY d.department_name, DATE_FORMAT(o.order_date, '%Y-%m');
该示例中,首先通过`orders`、`employees`和`departments`三张表获取完整的业务数据。随后,利用`DATE_FORMAT`函数将日期转换为年月字符串,作为第二个聚合维度。`GROUP BY`子句同时作用于部门名称和月份,使得结果集按这两个粒度进行分组,并计算订单数量和总金额。这种结构清晰地分离了数据关联阶段和数据聚合阶段,保证了逻辑的清晰性。
基于特定输入条件下聚合结果的准确性验证
当输入数据中存在空值或重复键时,多表关联与聚合的结果可能会受到显著影响。例如,如果关联键中存在`NULL`值,`INNER JOIN`会直接丢弃这些行,导致聚合结果偏低;而`LEFT JOIN`则会保留这些行,但关联字段为空。此外,如果一对多关系中,被关联表存在多条匹配记录,会导致主表行被复制,进而使聚合函数(如`SUM`)的结果虚高。因此,在处理此类问题时,必须仔细检查关联键的唯一性和非空约束,必要时使用`DISTINCT`或子查询预处理数据。
SELECT
    d.department_name,
    COUNT(DISTINCT o.id) as unique_orders,
    SUM(DISTINCT o.amount) as adjusted_total
FROM departments d
LEFT JOIN employees e ON d.id = e.department_id
LEFT JOIN orders o ON e.id = o.employee_id
GROUP BY d.department_name;
在上述代码中,使用了`LEFT JOIN`以保留没有员工或订单的部门。为了防止因一对多关系导致的金额重复计算,使用了`SUM(DISTINCT o.amount)`。虽然这不能完全解决所有重复问题(因为不同订单可能有相同金额),但在特定场景下是一种简化的修正手段。更严谨的做法是在聚合前使用子查询预先去重或汇总。此示例展示了如何处理可能产生重复行的关联场景,确保聚合结果的相对准确性。


















