








在sql server中通过索引视图物化预聚合结果,核心做法是创建一个带有唯一聚集索引的视图。这要求视图定义必须满足严格条件:使用schemabinding绑定架构、聚合函数仅引用基表列、且group by包含所有非聚合列。创建唯一聚集索引后,查询优化器会自动识别并替换查询中的基表访问,直接读取预计算的聚合数据,从而显著提升复杂统计查询的性能。

如何编写符合要求的聚合视图定义
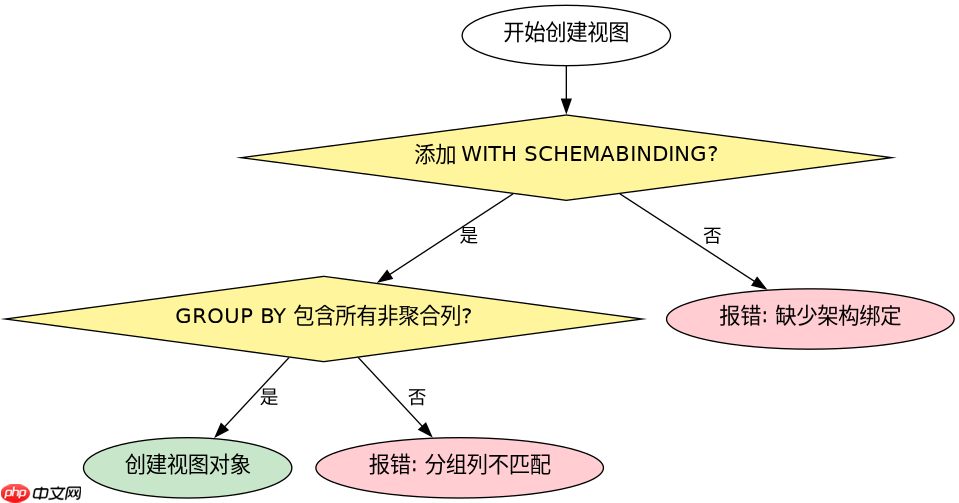
编写符合要求的聚合视图定义时,必须确保SELECT列表中包含所有用于分组的列以及对应的聚合函数。同时,必须在CREATE VIEW语句后追加WITH SCHEMABINDING子句,以防止基表结构变更导致视图失效。这种绑定机制是后续创建索引的前提,它确保了视图所依赖的对象结构在修改前会先检查视图依赖关系。
-- 创建带架构绑定的聚合视图
CREATE VIEW dbo.vw_SalesSummary
WITH SCHEMABINDING
AS
SELECT
    YEAR(OrderDate) AS OrderYear,
    MONTH(OrderDate) AS OrderMonth,
    ProductID,
    SUM(Quantity) AS TotalQuantity,
    SUM(Amount) AS TotalAmount
FROM dbo.Sales
GROUP BY
    YEAR(OrderDate),
    MONTH(OrderDate),
    ProductID;
上述代码定义了一个按年和月及商品ID汇总销售额的视图。注意GROUP BY子句必须与SELECT列表中的非聚合项完全一致。如果遗漏任何分组列,或者在聚合函数中引用了未分组的列,SQL Server将拒绝创建视图或后续的索引。这种严格的语法约束保证了数据的确定性和一致性,为物理存储奠定了基础。
如何创建唯一聚集索引以触发物化
仅仅创建视图并不会产生物理数据,必须在该视图上创建唯一的聚集索引(Unique Clustered Index)才能真正实现数据的物化。这个索引不仅定义了数据的物理存储顺序,还强制要求分组键组合的唯一性。一旦索引创建成功,SQL Server会在基表数据插入、更新或删除时自动维护该索引视图中的数据,使其始终与基表保持同步。
-- 在视图上创建唯一聚集索引
CREATE UNIQUE CLUSTERED INDEX IX_vw_SalesSummary
ON dbo.vw_SalesSummary (OrderYear, OrderMonth, ProductID);
执行上述命令后,系统会在后台建立一张与基表分离的物理表来存储聚合结果。此时,查询优化器开始具备选择是否使用该索引视图的能力。需要注意的是,只有当查询的谓词和分组条件能够被该索引覆盖时,优化器才会考虑使用它。此外,由于引入了唯一性约束,如果基表中存在重复的分组键组合,索引创建将会失败,需预先处理数据重复问题。
查询优化器在什么条件下会使用索引视图
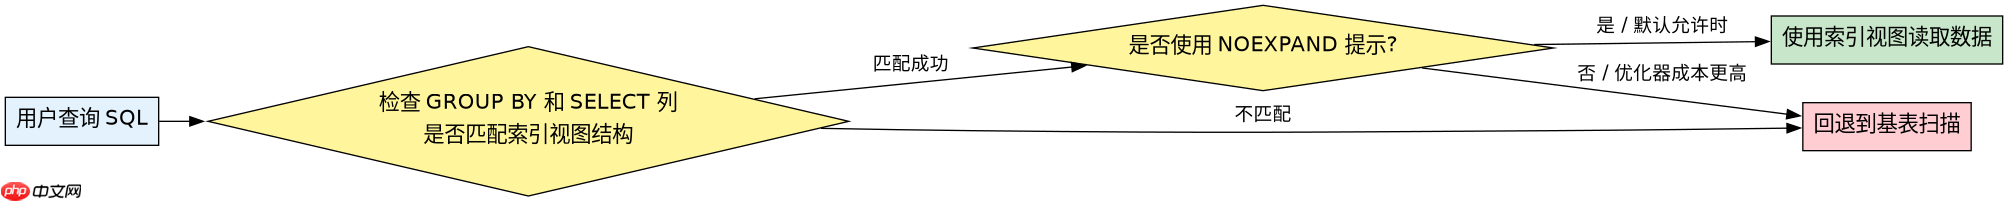
查询优化器使用索引视图并非默认行为,通常需要显式提示或特定的会话设置才能生效。默认情况下,即使创建了索引视图,优化器也可能因为成本估算偏差而忽略它。为了强制优化器考虑索引视图,可以在查询中使用NOEXPAND提示,或者启用ALLOW_USER_TRANSACTIONS选项。此外,查询中的GROUP BY子句必须与索引视图的键完全匹配,且SELECT列表中的列必须是索引视图中列的子集。
-- 使用 NOEXPAND 提示强制使用索引视图
SELECT OrderYear, OrderMonth, ProductID,
       SUM(TotalQuantity) AS Qty,
       SUM(TotalAmount) AS Amt
FROM dbo.vw_SalesSummary WITH (NOEXPAND)
GROUP BY OrderYear, OrderMonth, ProductID;
在实际应用中,建议先通过执行计划观察是否使用了索引视图。如果未使用,检查是否满足了所有匹配条件。例如,如果查询中包含了索引视图中不存在的列,或者WHERE子句过滤掉了所有可能的匹配行,优化器可能会选择回退到基表扫描。此外,对于频繁更新的表,维护索引视图的开销可能抵消查询加速的收益,因此需权衡读写比例后再决定是否采用此方案。

















