








在sql server中定位因join缺失索引产生的警报,核心方法是查询系统动态管理视图 sys.dm_db_missing_index_details 并结合 sys.dm_db_missing_index_groups 获取组信息。通过关联这些视图,可以筛选出涉及多表连接(join)且被标记为高成本的查询计划,从而精准定位需要优化的sql语句和具体缺失的索引结构。

如何识别包含JOIN的高成本缺失索引请求?
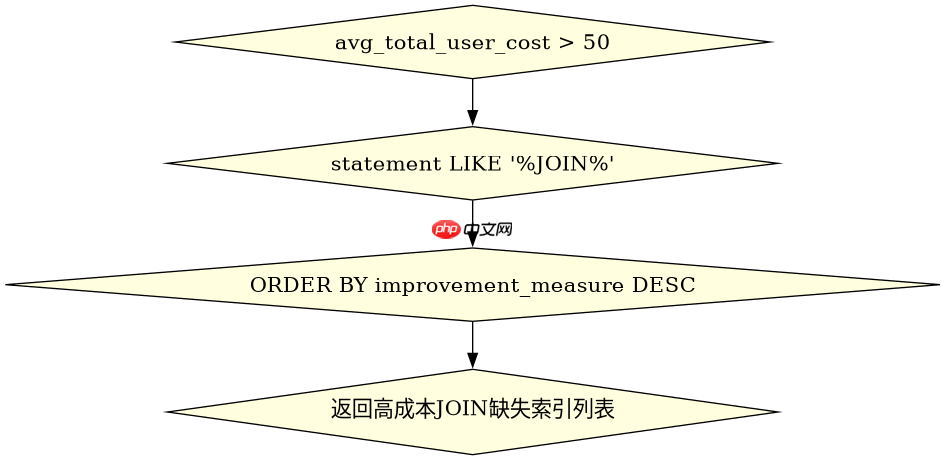
要识别包含JOIN的缺失索引,需从 sys.dm_db_missing_index_group_stats 视图中过滤 avg_total_user_cost 较高的记录,并通过 statement 字段确认是否包含JOIN操作。该视图提供了每个缺失索引组的统计信息,包括用户查询次数、平均节省成本和最后使用时间,帮助开发者优先处理影响最大的JOIN场景。
SELECT
    migs.avg_total_user_cost * (migs.avg_user_impact / 10.0) AS improvement_measure,
    mid.statement AS table_name,
    mig.group_handle,
    migs.user_seeks,
    migs.avg_total_user_cost
FROM sys.dm_db_missing_index_group_stats migs
INNER JOIN sys.dm_db_missing_index_groups mig ON migs.group_handle = mig.index_group_handle
INNER JOIN sys.dm_db_missing_index_details mid ON mig.index_handle = mid.index_handle
WHERE migs.avg_total_user_cost > 50
ORDER BY improvement_measure DESC;
上述查询返回按改进度量排序的结果,其中 table_name 显示参与JOIN的目标表名。若 statement 中包含 JOIN 关键字,则表明该缺失索引与连接操作相关。开发者可据此锁定具体的表和列组合,进一步分析执行计划以验证索引缺失对性能的影响。
如何将缺失索引建议转化为实际DDL语句?
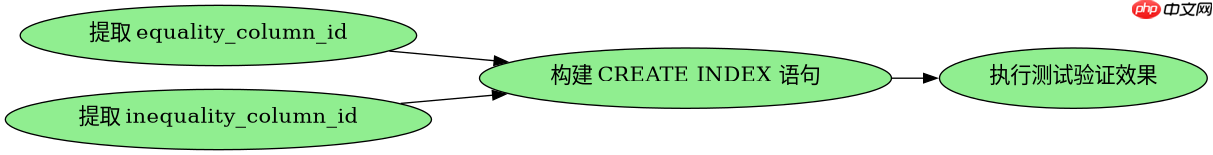
将缺失索引建议转化为实际DDL语句,需结合 sys.dm_db_missing_index_columns 视图提取等值条件(equality_column_id)和范围条件(inequality_column_id),并构建 CREATE INDEX 语句。该步骤确保生成的索引覆盖JOIN中的关键过滤和连接列,避免手动猜测导致的索引设计偏差。
SELECT
    'CREATE NONCLUSTERED INDEX IX_' + mid.object_id + '_' + REPLACE(REPLACE(REPLACE(mid.statement, '[', ''), ']', ''), '.', '_') +
    '_' + STRING_AGG(COL_NAME(mid.object_id, mic.column_id), '_') WITHIN GROUP (ORDER BY mic.column_id) AS ddl_script
FROM sys.dm_db_missing_index_details mid
INNER JOIN sys.dm_db_missing_index_columns(mid.index_handle) mic ON mid.index_handle = mic.index_handle
GROUP BY mid.object_id, mid.statement;
此脚本生成针对特定表的DDL语句,其中列名按顺序拼接以确保索引覆盖性。例如,若 mid.statement 为 [dbo].[Orders] 且涉及 CustomerID 和 OrderDate,则输出类似 CREATE NONCLUSTERED INDEX IX_123456_dbo_Orders_CustomerID_OrderDate ... 的语句。开发者可直接复制执行,或通过测试环境验证其对JOIN查询的提升效果。
当JOIN涉及三张以上表时,缺失索引警报如何区分主从关系?
当JOIN涉及三张以上表时,缺失索引警报通过 sys.dm_db_missing_index_details 中的 user_impact 字段区分主从关系,即影响程度最高的表通常作为驱动表或主连接点。高 user_impact 值表明该表的索引缺失对整体查询性能影响最大,应优先优化。

















