








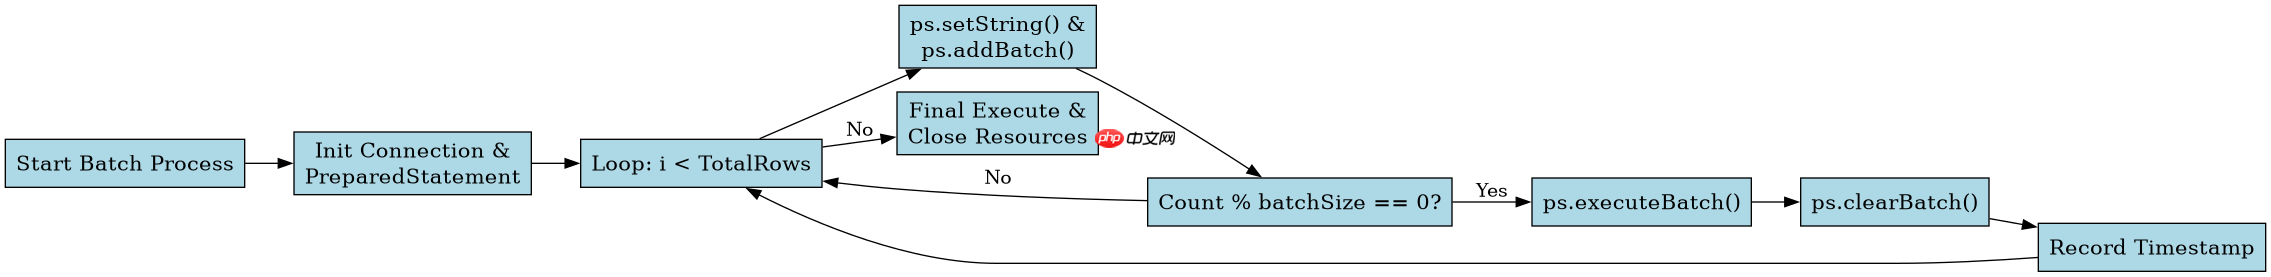
通过设置 statement 的 batchsize 属性并配合 addbatch() 与 executebatch() 方法,可以有效监控批量执行的性能。具体做法是在循环中添加语句后,当计数达到阈值时触发执行,记录每次批次的耗时,从而定位性能瓶颈。
如何配置 PreparedStatement 以启用批量处理
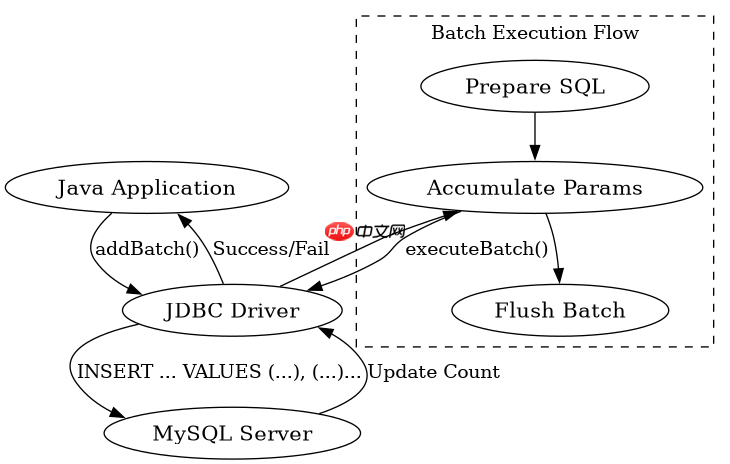
在 Java 中,JDBC 驱动默认可能不自动将多条 SQL 合并发送,需要显式开启批量模式。通过在连接 URL 或 Statement 级别设置 rewriteBatchedStatements=true(针对 MySQL)或直接调用 addBatch() 来累积命令。核心在于利用 PreparedStatement 的预编译特性减少解析开销,并通过分批提交降低网络往返次数。
import java.sql.*;

public class BatchMonitor {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        try (Connection conn = DriverManager.getConnection(url, "user", "pass");
             PreparedStatement ps = conn.prepareStatement("INSERT INTO users (name) VALUES (?)")) {

            int batchSize = 1000;
            int count = 0;
            long startTime = System.currentTimeMillis();

            for (int i = 0; i < 5000; i++) {
                ps.setString(1, "User_" + i);
                ps.addBatch();
                count++;

                if (count % batchSize == 0) {
                    ps.executeBatch();
                    ps.clearBatch();
                    System.out.println("Batch " + (count/batchSize) + " executed at " + System.currentTimeMillis());
                }
            }
            if (count % batchSize != 0) {
                ps.executeBatch();
            }
            long endTime = System.currentTimeMillis();
            System.out.println("Total time: " + (endTime - startTime) + "ms");
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
上述代码演示了每 1000 条记录执行一次批处理的逻辑。预期结果是控制台输出每个批次的完成时间戳,以及最终的总耗时。通过对比不同 batchSize 下的总耗时,可以确定最佳批次大小。注意 clearBatch() 必须在 executeBatch() 之后调用,否则会导致重复插入。
立即学习“Java免费学习笔记(深入)”;

如何计算和分析批量执行的耗时分布
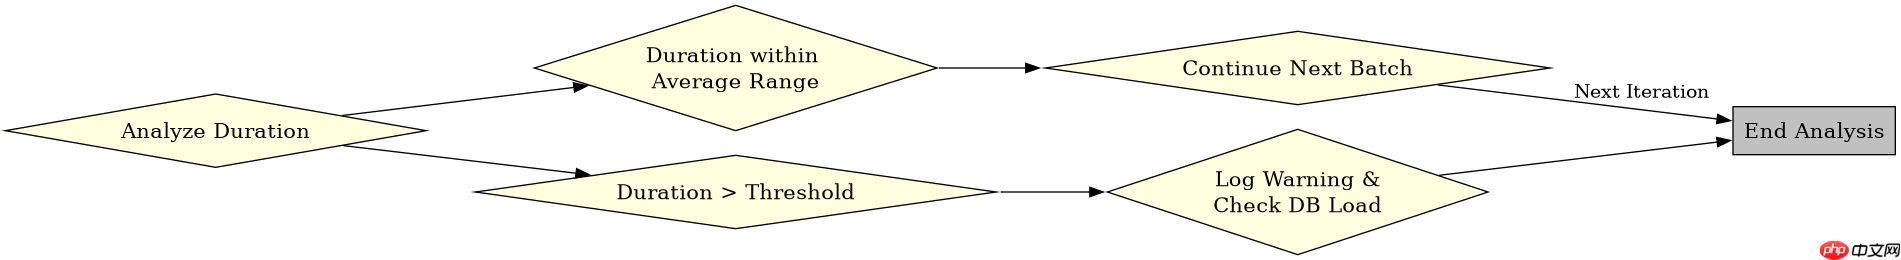
为了更精细地监控性能,需要在每次 executeBatch() 调用前后记录时间戳,计算单次批次的处理时长。这有助于发现是否存在某些批次因数据量过大或数据库负载波动而变慢。通过分析这些时间点的分布,可以判断是 CPU 瓶颈、I/O 等待还是网络延迟导致的问题。
// 在循环内部替换之前的 executeBatch 部分
long batchStart = System.nanoTime();
ps.executeBatch();
long batchEnd = System.nanoTime();
double durationMs = (batchEnd - batchStart) / 1_000_000.0;
System.out.printf("Batch %d took %.2f ms%n", count/batchSize, durationMs);
这段代码片段展示了如何获取纳秒级精度并转换为毫秒。预期输出会显示类似 "Batch 1 took 12.50 ms" 的信息。如果某个批次耗时显著高于平均值,可能需要检查该批次包含的数据是否有特殊字符或长度异常,或者数据库当时是否在进行垃圾回收等后台任务。
当 PreparedStatement 参数类型不一致时会发生什么
如果在同一个批次中混用了不同类型的参数(例如先设字符串再设整数),虽然 PreparedStatement 允许动态设置参数类型,但 JDBC 驱动在处理批量时可能会因为类型转换开销或元数据缓存失效而导致性能下降。此外,如果参数类型与数据库列定义严重不符,可能在 executeBatch() 时抛出 SQLException。保持参数类型的一致性有助于驱动优化批量执行路径。


















