








sql窗口函数不能直接嵌套,因为标准sql语法规定窗口函数只能出现在查询的select列表或order by子句中,且其参数必须是列名、表达式或另一个非聚合的非窗口函数,严禁将另一个窗口函数的调用作为外层窗口函数的参数。要规避这一限制,必须采用分层处理策略:先通过子查询或cte(公共表表达式)计算内层窗口函数的结果并赋予别名,然后在外部查询中基于该别名再次应用外层窗口函数。
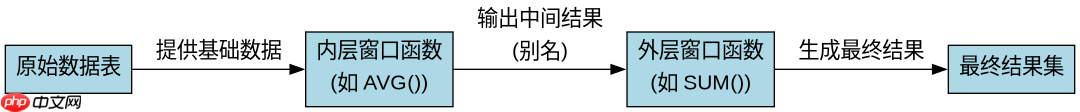
为什么SQL引擎拒绝嵌套窗口函数
SQL引擎拒绝嵌套窗口函数是因为逻辑执行顺序的限制。在SQL的标准执行流程中,窗口函数的计算发生在数据分组和排序之后,但在GROUP BY和HAVING之前。如果允许嵌套,例如 SUM(AVG(salary)) OVER (...),引擎将无法确定内层 AVG 是在哪个粒度上计算的,以及外层 SUM 应该对什么数据进行聚合。这种语义上的模糊性导致大多数数据库系统(如MySQL、PostgreSQL、SQL Server)在解析阶段直接报错,提示不支持在窗口函数中使用其他窗口函数。因此,开发者必须显式地划分计算层级,避免让引擎在单次扫描中同时处理多层级的窗口逻辑。
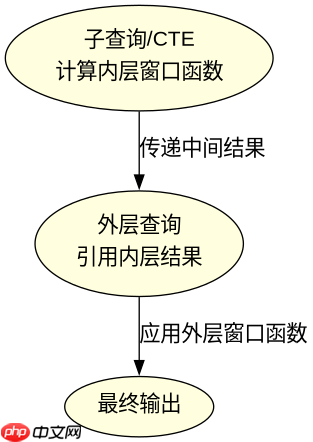
WITH InnerCalc AS ( SELECT department_id, salary, AVG(salary) OVER (PARTITION BY department_id) AS dept_avg_salary FROM employees)SELECT department_id, salary, dept_avg_salary, SUM(dept_avg_salary) OVER (PARTITION BY department_id) AS total_dept_avgFROM InnerCalc;
上述代码展示了标准的规避方案。首先,在CTE InnerCalc 中计算每个部门的平均工资 dept_avg_salary。然后,在外层查询中,直接引用这个别名进行进一步的聚合操作。这种写法不仅符合SQL语法,而且逻辑清晰,易于维护。需要注意的是,虽然某些数据库可能支持更复杂的嵌套,但为了跨平台兼容性,始终推荐使用这种分层结构。
如何在复杂场景下优化多层窗口计算
在处理需要多层窗口计算的复杂场景时,除了使用CTE,还可以考虑使用临时表或视图来存储中间结果,从而提升查询性能。此外,对于某些特定的数据库系统,如Oracle,可能支持更高级的窗口函数特性,但即便如此,分层处理仍然是最佳实践。通过这种方式,可以确保每一步计算都是明确且可预测的,避免了因嵌套导致的性能瓶颈和逻辑错误。
-- 假设我们需要计算每个员工在其部门内的排名,以及该排名的累计值WITH RankedEmployees AS ( SELECT employee_id, department_id, salary, RANK() OVER (PARTITION BY department_id ORDER BY salary DESC) as rank_in_dept FROM employees)SELECT employee_id, department_id, salary, rank_in_dept, SUM(rank_in_dept) OVER (PARTITION BY department_id ORDER BY salary DESC ROWS UNBOUNDED PRECEDING) as cumulative_rankFROM RankedEmployees;
在这个例子中,我们首先计算了每个员工在其部门内的薪资排名 rank_in_dept。然后,在外层查询中,我们计算了该排名的累计值。这种分层处理方式不仅解决了嵌套问题,还使得查询逻辑更加清晰和易于理解。通过这种方式,我们可以有效地处理复杂的业务需求,同时保持代码的可读性和可维护性。
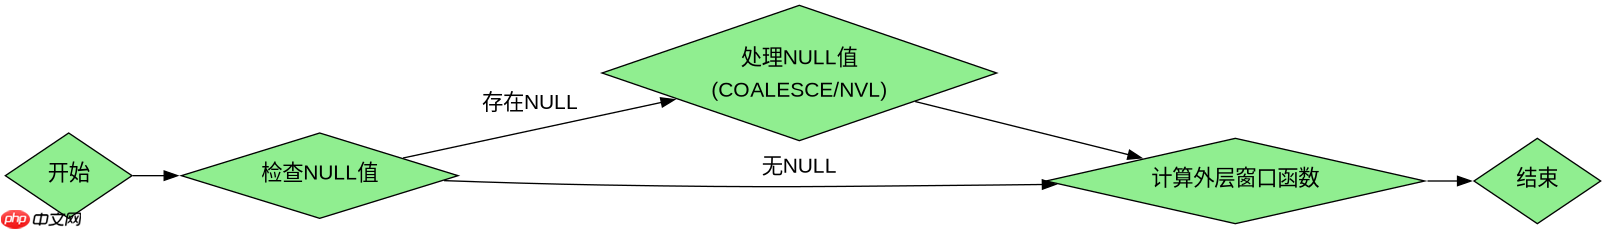
当内层窗口函数返回NULL时外层如何处理
当内层窗口函数由于空值或过滤条件返回NULL时,外层窗口函数通常会继续处理这些NULL值,具体行为取决于外层函数的实现。例如,SUM(NULL) 会忽略NULL值,而 AVG(NULL) 也会忽略NULL值。然而,如果外层函数是 COUNT(*),则会统计包括NULL在内的所有行。因此,在处理多层窗口计算时,需要特别注意NULL值的处理逻辑,以确保结果的准确性。可以通过使用 COALESCE 或 NVL 函数将NULL值替换为默认值,以避免潜在的计算错误。


















