








使用子查询安全删除重复数据的核心做法是:先通过 group by 和 having 找出重复组,再保留每组中 id 最小(或最大)的一条记录,最后 delete 掉其余行。具体操作时,利用自连接或 in 子查询匹配重复键值但排除保留行的主键,确保只删除冗余数据而不影响业务主记录。

如何识别并定位重复数据组
在删除前,必须明确哪些字段构成“重复”的唯一标准,通常是指除主键外的业务字段完全一致。例如,若用户表中有 email 字段,两个不同 id 的用户拥有相同 email 即视为重复。我们可以通过 SELECT 语句配合 COUNT() 和 GROUP BY 来列出所有重复组及其包含的记录数,从而确认需要清理的范围。这一步不涉及删除,仅用于验证数据状态。
SELECT email, COUNT(*) as cnt
FROM users
GROUP BY email
HAVING cnt > 1;
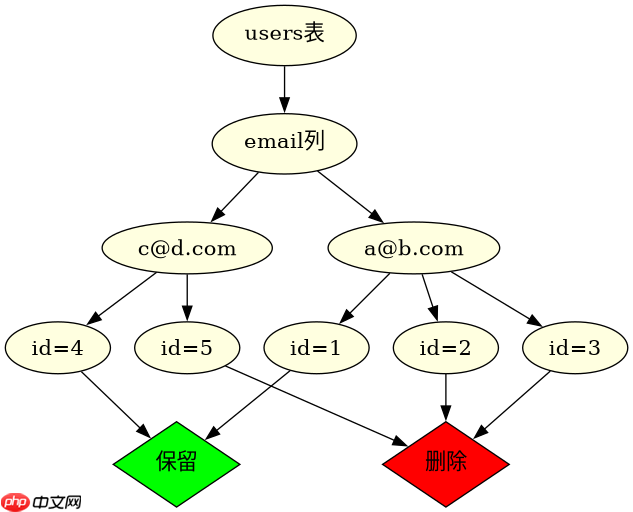
上述查询返回每个重复 email 及其出现次数。假设结果如下:
email | cnt
------|----
a@b.com | 3
c@d.com | 2
这表明 a@b.com 有 3 条重复记录,c@d.com 有 2 条。接下来需确定保留哪一条。通常保留 id 最小的那条,因为它是最早创建的记录,具有更高的可信度。因此,保留策略为:对每个重复组,保留 MIN(id),删除其他所有 id 更大的记录。
如何编写安全的 DELETE 语句删除重复项
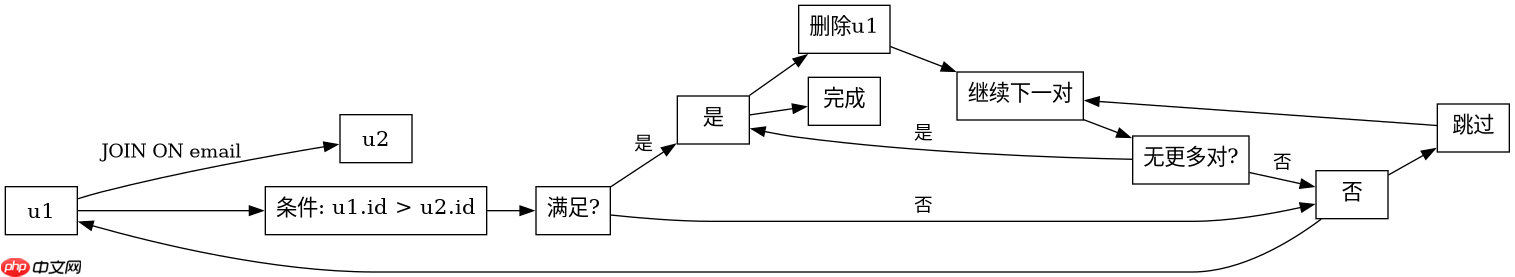
基于上一节确定的保留策略,我们可以构造 DELETE 语句。关键在于准确识别那些“不应被保留”的行。一种常见且高效的写法是使用自连接:将表与自身连接,条件是两个记录的重复键相同,但当前记录的 id 大于另一条记录的 id。这样,对于每个重复组,只有 id 最大的那条会被选中删除;如果有多条可删,则逐次执行直到只剩一条。另一种方式是使用子查询 IN 列表,直接排除保留的 min_id。
DELETE u1 FROM users u1
INNER JOIN users u2
WHERE u1.email = u2.email AND u1.id > u2.id;
该语句的逻辑是:对于每一对具有相同 email 的记录,如果 u1 的 id 大于 u2 的 id,则删除 u1。由于 MySQL 在执行此类自连接 DELETE 时会按内部顺序处理,最终每个重复组只会保留 id 最小的那条。例如,对于 a@b.com 的三条记录(id=1,2,3),当比较 (1,2) 时,id=2 > id=1,故 id=2 被标记删除;比较 (1,3) 时,id=3 > id=1,故 id=3 被标记删除;比较 (2,3) 时,id=3 > id=2,但 id=2 已被删除,所以不再参与。最终保留 id=1。此方法无需显式指定保留哪个 id,依赖的是 id 的自然大小关系,简洁且可靠。
删除后如何验证剩余数据的唯一性
执行删除操作后,必须验证是否真正消除了重复。最直接的验证方式是再次运行第一节中的 SELECT 查询,检查是否还有任何 email 的计数大于 1。如果结果为空,说明所有重复组都已处理完毕。此外,还可以检查总行数是否符合预期:原始行数减去重复组的多余记录数应等于当前行数。例如,原表有 100 行,其中 a@b.com 重复 3 次(多 2 条),c@d.com 重复 2 次(多 1 条),则删除后应为 97 行。若实际行数不符,可能因部分记录未被正确匹配或删除失败,需重新审视 DELETE 语句的条件或检查是否有并发写入干扰。
















