








利用sql窗口函数在分组内计算累计求和运行总计,核心是使用 sum() 聚合函数配合 over() 子句。具体做法是定义 partition by 指定分组列,并在 order by 中指定排序列,同时确保不设置 range 或 rows 边界限制(或使用默认的 range unbounded preceding),这样数据库会按行顺序累加当前行之前的所有值。

SUM() 窗口函数的基本语法结构是怎样的
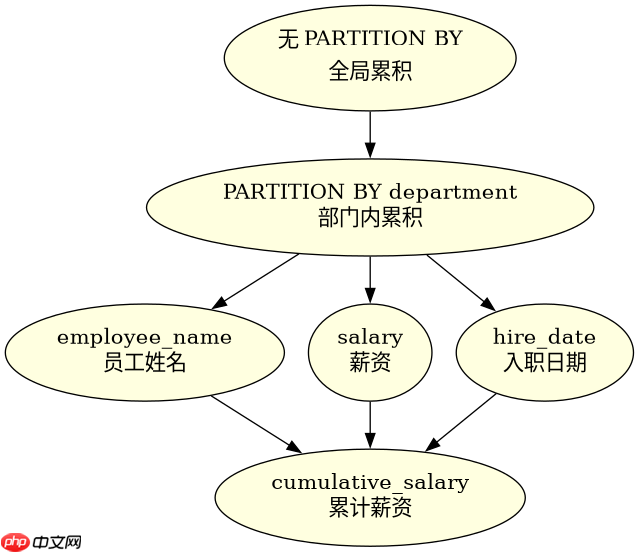
该函数的基本语法结构为 SUM(column_name) OVER (PARTITION BY group_column ORDER BY sort_column)。PARTITION BY 负责将数据划分为不同的逻辑组,ORDER BY 决定组内数据的累积顺序。如果不指定 ORDER BY,则会对整个分区进行总和计算而非逐行累积;如果只指定 ORDER BY 而不指定 PARTITION BY,则是对全表数据进行全局累积。
SELECT
    department,
    employee_name,
    salary,
    SUM(salary) OVER (
        PARTITION BY department
        ORDER BY hire_date
    ) AS cumulative_salary
FROM employees;
预期结果:对于每个部门,按照入职日期排序,逐行显示该员工及其之前所有员工的薪资总和。例如,若某部门有两名员工 A 和 B,A 先入职,B 后入职,则 A 的累计薪资为 A 的薪资,B 的累计薪资为 A 的薪资加上 B 的薪资。
如何处理分组内的重复值以确保累积正确性
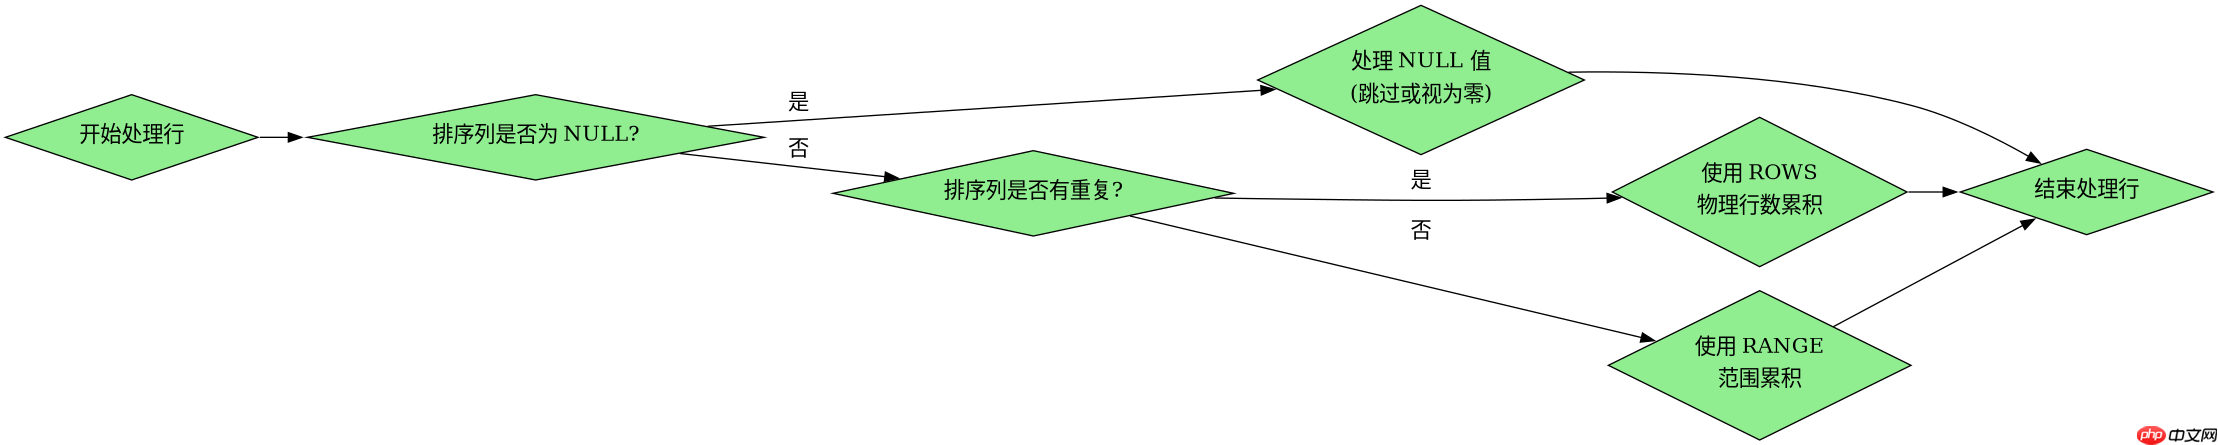
当分组内的排序列存在重复值时,默认行为取决于数据库实现,通常使用 RANGE 语义,即相同排序值的行会被视为同一范围一起累积。为确保每行独立累积,应使用 ROWS 子句明确指定物理行数范围,如 ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW。这样可以避免重复值导致的意外分组累积,保证每一行都基于前一行物理位置进行累加。
SELECT
    department,
    employee_name,
    salary,
    SUM(salary) OVER (
        PARTITION BY department
        ORDER BY hire_date
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS cumulative_salary
FROM employees;
预期结果:即使多名员工在同一天入职(hire_date 相同),他们的累计薪资也会按照查询返回的物理顺序逐行累加,而不是将所有同日入职的员工视为一组同时计算总和。这确保了累积过程的线性性和可预测性。
如果分组内没有数据或排序列为空会返回什么
如果分组内没有数据,窗口函数不会返回任何行,因为 OVER() 是基于现有行计算的。如果排序列为 NULL,不同数据库对 NULL 的处理不同:在 ORDER BY 中,NULL 通常被视为最小值或最大值(取决于 ASC/DESC 和数据库设置)。在累积求和中,NULL 值通常被跳过或视为零,具体取决于 SUM() 的实现。建议在使用前检查数据完整性,避免 NULL 导致的不确定行为。

















