








在sql中处理并列排名时,使用 dense_rank() 窗口函数可以确保相同分数的记录获得相同的排名,且后续排名连续不跳跃。具体做法是在 select 语句中调用 dense_rank() over (order by score desc),其中 score 是用于排序的列名。这样做会得到一个名为 rank 的结果列,其值对于并列者相同,且下一个不同分数的排名紧接前一个最大排名(例如两个第1名后直接是第3名)。若存在空值,默认会排在最后或最前取决于数据库实现,通常建议显式处理。

DENSE_RANK与ROW_NUMBER在处理并列时的区别是什么
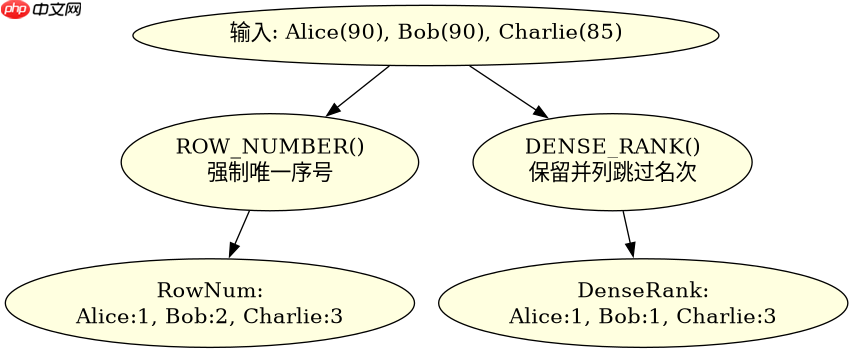
DENSE_RANK() 与 ROW_NUMBER() 的核心区别在于对并列值的处理方式:ROW_NUMBER() 强制为每行分配唯一序号,即使分数相同也会产生连续不同的排名(如1, 2, 3),而 DENSE_RANK() 保持并列值排名一致并跳过后续名次(如1, 1, 3)。要验证这一差异,只需将窗口函数替换为 ROW_NUMBER() 并观察输出结果的变化。
WITH scores AS (
  SELECT 'Alice' AS name, 90 AS score
  UNION ALL SELECT 'Bob', 90
  UNION ALL SELECT 'Charlie', 85
)
SELECT
  name,
  score,
  DENSE_RANK() OVER (ORDER BY score DESC) AS dense_rank,
  ROW_NUMBER() OVER (ORDER BY score DESC) AS row_num
FROM scores;
预期结果:Alice和Bob的 dense_rank 均为1,Charlie为2;而 row_num 分别为1、2、3。这证明了 DENSE_RANK 保留并列但跳过名次,ROW_NUMBER 则无并列。
DENSE_RANK在分组统计中的典型应用场景有哪些
DENSE_RANK() 常结合 PARTITION BY 子句用于组内排名,例如在每个部门内找出薪资最高的员工,或计算每个类别下的Top N记录。通过指定分区列,排名会在每个组内独立重置,从而实现局部最优解的筛选。这种场景下,输入数据需包含分组标识和排序依据,输出则是带有组内排名的明细表。

WITH dept_salaries AS (
  SELECT 'Engineering' AS dept, 'Alice' AS name, 9000 AS salary
  UNION ALL SELECT 'Engineering', 'Bob', 9000
  UNION ALL SELECT 'Engineering', 'Charlie', 8000
  UNION ALL SELECT 'HR', 'David', 7000
  UNION ALL SELECT 'HR', 'Eve', 6000
)
SELECT
  dept,
  name,
  salary,
  DENSE_RANK() OVER (PARTITION BY dept ORDER BY salary DESC) AS dept_rank
FROM dept_salaries;
预期结果:Engineering部门中Alice和Bob的 dept_rank 为1,Charlie为2;HR部门中David为1,Eve为2。这表明 DENSE_RANK 能有效支持按组别进行并列排名统计。
当DENSE_RANK遇到NULL值时排名行为如何确定
当 DENSE_RANK() 处理的列中包含 NULL 值时,其行为取决于具体的SQL数据库系统。在大多数主流数据库(如PostgreSQL、MySQL 8.0+、SQL Server)中,NULL 被视为最小值,因此在 ORDER BY ... DESC 时会排在最后,而在 ORDER BY ... ASC 时会排在最前。这意味着 NULL 值可能会获得一个特定的排名,或者如果所有值都是 NULL,则都获得相同的排名。为了控制这种行为,通常建议在查询前使用 COALESCE 或 NVL 函数将 NULL 转换为默认值,或在 ORDER BY 中明确指定 NULLS LAST / NULLS FIRST(如果数据库支持)。


















