








sql子查询写在join on条件中会导致性能急剧恶化,核心原因是优化器无法正确评估数据量,从而被迫放弃高效的哈希连接或合并连接,退化为嵌套循环连接(nested loop join),导致内表被重复扫描多次。具体做法是避免在on子句中直接使用非等值关联的子查询,应将其改写为临时表、cte(公用表表达式)或直接使用left join配合where过滤,这样优化器才能准确统计基数并选择最优执行计划。

为什么ON子句中的子查询会破坏基数估计?
当你在JOIN的ON条件里放一个子查询时,数据库优化器往往难以预测该子查询返回多少行。如果优化器低估了行数,它可能会选择一个看似高效但实际极慢的执行策略。例如,对于每一行外表的数据,优化器可能认为只需要检查很少的内表数据,于是选择了嵌套循环。但实际上,子查询可能返回大量数据,导致内表被反复全表扫描。这种“每行一次”的扫描模式随着数据量增加呈指数级增长,这就是性能急剧恶化的根本原因。
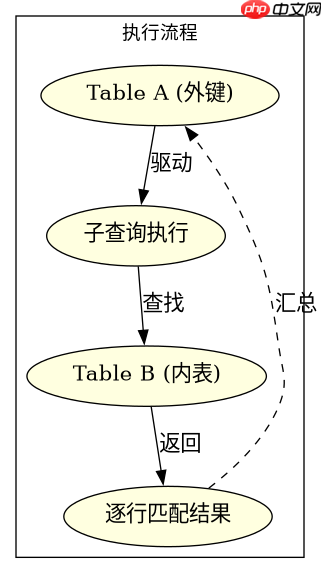
SELECT a.id, a.name, (SELECT b.value FROM table_b b WHERE b.a_id = a.id) as val
FROM table_a a;
上述代码展示了典型的标量子查询场景。虽然语法简洁,但执行时会对table_a的每一行都执行一次子查询。如果table_a有10万行,子查询就要执行10万次。相比之下,如果使用JOIN,优化器可以一次性构建索引或哈希表,将复杂度降低到线性级别。因此,在涉及大数据量时,务必将此类逻辑转换为显式的JOIN操作。
如何正确改写ON子句中的子查询以提升性能?
解决这一问题的标准做法是将子查询提取出来,转化为独立的查询块,并通过JOIN或WHERE子句进行关联。这样可以确保优化器能够独立统计每个表的基数,并选择合适的连接算法。推荐使用CTE或临时表来预处理子查询结果,或者直接使用LEFT JOIN配合IS NULL判断来实现反连接效果。这种方法不仅提升了可读性,更让优化器有了更多的执行计划选择空间。

-- 错误写法:子查询在ON中
SELECT * FROM table_a a
JOIN table_b b ON a.id = b.a_id AND (SELECT COUNT(*) FROM table_c c WHERE c.b_id = b.id) > 0;

-- 正确写法:使用EXISTS或预计算
SELECT * FROM table_a a
JOIN table_b b ON a.id = b.a_id
WHERE EXISTS (SELECT 1 FROM table_c c WHERE c.b_id = b.id);
通过对比可以看出,使用EXISTS或预计算的JOIN能让优化器更好地处理数据流。特别是当子查询涉及聚合或复杂过滤时,提前计算并存储结果能显著减少运行时开销。开发者在重构SQL时,应优先检查ON子句中的复杂逻辑,将其移至WHERE或HAVING子句,或拆分为独立的CTE,以确保执行计划的稳定性。
基于程序中某个输入、条件或结果的具体问题
在实际开发中,如果程序传入的参数导致子查询返回空值或默认值,可能会引发意外的逻辑分支。例如,当子查询用于判断是否存在关联记录时,若未正确处理NULL,可能导致主记录被错误过滤。建议在使用子查询前,先验证其返回值类型,并在应用层增加空值保护逻辑,以避免因数据库行为差异导致的Bug。


















