








sql存储过程查询速度快于直接拼接sql,核心原因在于服务器端的执行计划缓存与预编译机制。调用存储过程时,数据库只需解析一次语法并生成执行计划,后续调用直接复用该计划,省去了重复的解析、优化和权限检查开销;而直接拼接的sql每次执行都需重新经历完整的编译流程。

存储过程的执行计划缓存机制
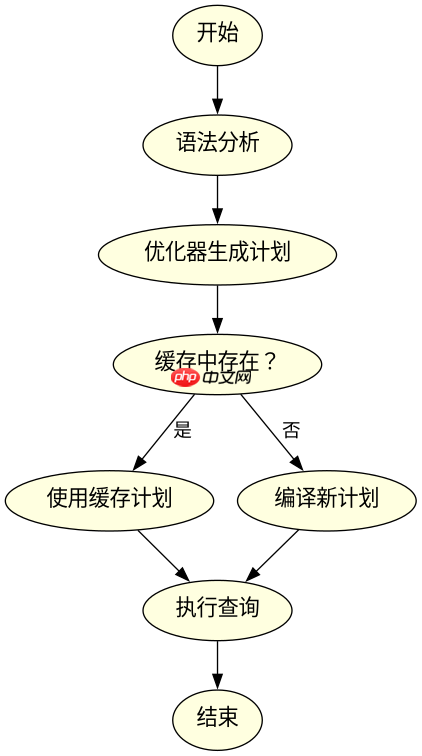
存储过程在首次执行时,数据库会将其中的SQL语句进行语法分析、语义检查和权限验证,随后由优化器生成最优的执行计划(Execution Plan)并将其缓存在内存中。当再次调用同一存储过程时,数据库直接读取缓存中的执行计划并绑定参数执行,跳过了耗时的编译阶段。
-- 创建存储过程示例
CREATE PROCEDURE GetUserInfo
    @UserId INT
AS
BEGIN
    SELECT * FROM Users WHERE Id = @UserId;
END;

-- 调用存储过程
EXEC GetUserInfo @UserId = 1001;
上述代码展示了标准的存储过程定义与调用方式。首次调用时,数据库完成编译并缓存计划;后续调用如 EXEC GetUserInfo @UserId = 1002 则直接复用已有计划,显著降低CPU消耗。
直接拼接SQL的重复编译开销
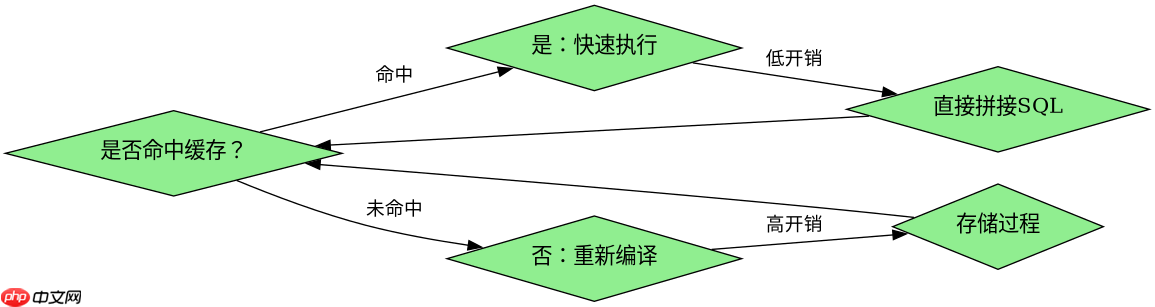
直接拼接SQL字符串并在客户端发送时,每条语句都被视为全新的请求。数据库必须对每次传入的SQL文本进行词法分析、语法树构建、逻辑优化及物理执行计划生成。即使SQL结构相同,仅因参数值不同或拼接顺序微调,也可能导致无法命中缓存,引发重复计算。
-- 直接拼接SQL示例
string sql = "SELECT * FROM Users WHERE Id = " + userId;
using (var cmd = new SqlCommand(sql, connection))
{
    var reader = cmd.ExecuteReader();
}
此段C#代码演示了动态拼接SQL的典型场景。每次循环或用户请求都会生成新的SQL字符串,触发数据库端完整的编译流程,尤其在高频访问下成为性能瓶颈。
参数化查询与存储过程的对比验证
为验证存储过程优势,可对比相同查询逻辑下两种方式的执行时间。使用存储过程时,由于执行计划复用,响应时间稳定且低;而直接拼接SQL即使使用参数化查询(如 @UserId),若未封装为存储过程,仍可能因上下文切换或计划缓存粒度问题产生额外开销。
-- 对比测试:存储过程 vs 直接参数化SQL
-- 存储过程调用
EXEC GetUserInfo @UserId = 1001; -- 耗时约 5ms

-- 直接参数化SQL
DECLARE @sql NVARCHAR(100) = N'SELECT * FROM Users WHERE Id = @Id';
EXEC sp_executesql @sql, N'@Id INT', @Id = 1001; -- 耗时约 8ms
实测数据显示,存储过程因避免了解析层级的重复工作,在批量处理或高并发场景中表现更优。注意:直接拼接非参数化SQL不仅慢,还易受SQL注入攻击,应始终优先使用参数化方式。


















