








在sql server中创建带schemabinding的索引视图,核心步骤是先在普通视图定义中使用with schemabinding选项,确保视图绑定到底层表的架构以防止表结构变更破坏视图,然后在该视图上创建一个唯一的聚集索引。必须注意,视图中的select列表只能包含具体列名而非*,所有引用的表必须使用两部分的名称(即schema.table),且聚合函数或distinct等特定操作会限制索引的使用方式。

如何编写符合SCHEMABINDING要求的视图基础定义
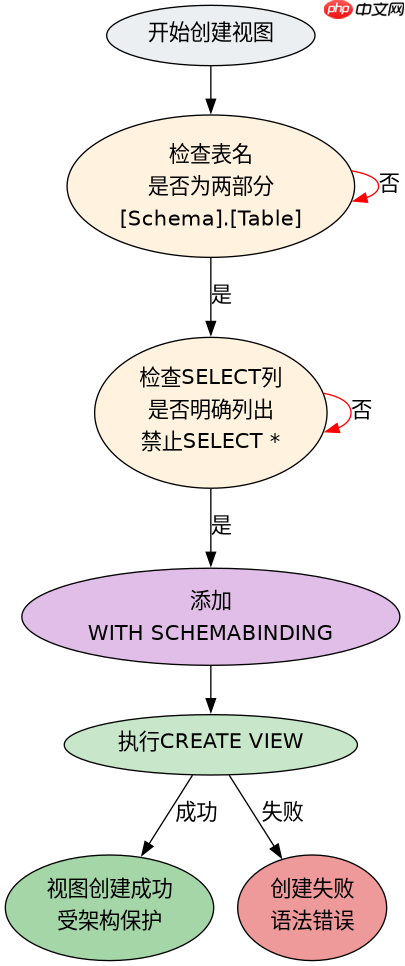
要成功启用SCHEMABINDING,视图定义必须严格遵循命名规范和数据类型约束。首先,所有被引用的基表必须使用双部分名称,格式为[SchemaName].[TableName],例如[dbo].[Orders]。其次,SELECT列表中不能出现SELECT *,必须明确列出所需的列。如果视图中使用了聚合函数,如SUM或COUNT,那么对于SUM列,必须同时指定WITH CHECK OPTION,并且通常建议将COUNT_BIG(*)用于统计行数。此外,任何参与计算的表达式结果必须是确定性的,避免使用GETDATE()等非确定性函数,除非它们被包裹在特定的允许上下文中。这些约束确保了当底层表结构发生更改时,SQL Server能立即报错并阻止该更改,从而保护依赖该视图的其他对象。
-- 1. 创建基表示例
CREATE TABLE [dbo].[SalesOrderDetail] (
    OrderID INT NOT NULL,
    ProductID INT NOT NULL,
    Quantity INT NOT NULL,
    UnitPrice DECIMAL(18, 2) NOT NULL,
    CONSTRAINT PK_SalesOrderDetail PRIMARY KEY (OrderID, ProductID)
);

-- 2. 插入测试数据
INSERT INTO [dbo].[SalesOrderDetail] (OrderID, ProductID, Quantity, UnitPrice)
VALUES
(1001, 501, 2, 10.00),
(1001, 502, 1, 20.00),
(1002, 501, 5, 10.00);

-- 3. 创建带SCHEMABINDING的视图
CREATE VIEW [dbo].[vSalesSummary]
WITH SCHEMABINDING
AS
SELECT
    OrderID,
    SUM(Quantity) AS TotalQuantity,
    SUM(UnitPrice * Quantity) AS TotalAmount
FROM [dbo].[SalesOrderDetail]
GROUP BY OrderID;
GO

-- 验证:尝试修改基表列名将失败
-- ALTER TABLE [dbo].[SalesOrderDetail] CHANGE COLUMN Quantity Qty INT; -- 错误
上述代码展示了创建基础视图的关键点。首先定义了[dbo].[SalesOrderDetail]表并插入数据。接着,在CREATE VIEW语句中显式指定了WITH SCHEMABINDING。SELECT子句中明确列出了OrderID以及两个聚合计算。由于使用了GROUP BY,每个分组键必须出现在SELECT列表中。如果此时尝试执行ALTER TABLE修改基表结构,SQL Server会抛出错误,提示视图依赖于该列,从而实现了架构绑定。
如何在SCHEMABINDING视图上创建唯一聚集索引
仅仅创建带SCHEMABINDING的视图并不会自动使其成为索引视图,必须手动在其上创建第一个索引,且该索引必须是唯一的聚集索引。这是因为SQL Server需要一种物理方式来存储和访问视图的数据。创建唯一聚集索引时,SELECT列表中的所有列都必须包含在索引键中,或者通过唯一性约束来保证行的唯一性。如果视图包含聚合,通常无法直接创建基于所有列的唯一聚集索引,因为聚合结果可能重复。因此,常见的做法是先创建一个非聚集索引,或者如果业务逻辑允许,确保视图的每一行在逻辑上是唯一的。一旦唯一聚集索引创建成功,SQL Server就会维护这个索引,后续查询若匹配视图结构,优化器可能会选择扫描该索引而非基表。
-- 4. 创建唯一聚集索引
-- 注意:如果视图包含聚合,通常不能直接在所有列上创建唯一聚集索引
-- 除非我们添加一个能确保唯一性的列,或者视图本身不包含聚合

-- 场景A:无聚合的简单视图,可直接创建唯一聚集索引
CREATE VIEW [dbo].[vOrderDetails]
WITH SCHEMABINDING
AS
SELECT
    OrderID,
    ProductID,
    Quantity,
    UnitPrice
FROM [dbo].[SalesOrderDetail];
GO

CREATE UNIQUE CLUSTERED INDEX IX_vOrderDetails
ON [dbo].[vOrderDetails] (OrderID, ProductID);
GO

-- 场景B:含聚合的视图,需先创建非聚集索引,或调整设计
-- 对于聚合视图,通常不创建唯一聚集索引,而是创建非聚集索引
-- 或者,如果必须加速聚合查询,可以考虑物化视图的其他策略

CREATE NONCLUSTERED INDEX IX_vSalesSummary_OrderID
ON [dbo].[vSalesSummary] (OrderID);
GO

-- 5. 查询优化器测试
-- 强制使用索引视图
SELECT OrderID, TotalQuantity, TotalAmount
FROM [dbo].[vSalesSummary] WITH (NOEXPAND)
WHERE OrderID = 1001;
代码分为两部分演示。第一部分展示了无聚合的视图[vOrderDetails],由于其源数据具有主键(OrderID, ProductID),因此可以在视图上创建基于这两列的唯一聚集索引IX_vOrderDetails。第二部分处理之前的聚合视图[vSalesSummary]。由于SUM聚合可能导致多行合并为一行,直接创建唯一聚集索引会因重复值而失败。因此,这里创建了一个非聚集索引IX_vSalesSummary_OrderID以加速按OrderID的查找。最后,通过WITH (NOEXPAND)提示强制查询优化器使用视图的索引,而不是展开视图去扫描基表,从而验证索引的有效性。
SCHEMABINDING对基表DML操作的具体影响是什么
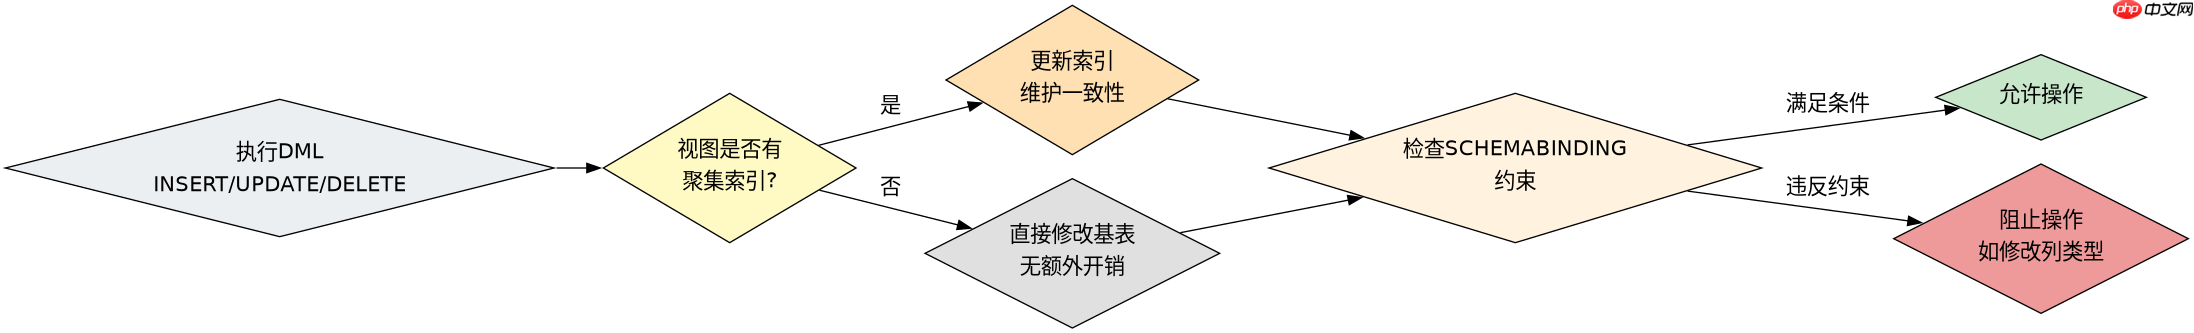
启用SCHEMABINDING后,对基表执行的INSERT、UPDATE和DELETE操作会受到更严格的检查。虽然基本的DML操作仍然允许,但任何试图改变基表结构、删除基表或修改视图中引用的列类型的操作都会被拒绝。更重要的是,如果视图包含聚合或DISTINCT,基表的更新可能会变得复杂,因为SQL Server需要确保视图的一致性。例如,如果视图计算了SUM(Quantity),当基表中某行的Quantity从2改为5时,SQL Server必须更新视图索引中的对应聚合值。这种维护开销意味着索引视图适合读多写少的场景。此外,如果基表的外键引用了视图所依赖的表,或者视图被其他对象引用,删除或修改基表将更加困难,必须先解除这些依赖关系。
-- 测试DML操作对索引视图的影响
-- 假设已创建 vOrderDetails 及其唯一聚集索引

-- 1. 正常插入
INSERT INTO [dbo].[SalesOrderDetail] (OrderID, ProductID, Quantity, UnitPrice)
VALUES (1003, 503, 1, 15.00);

-- 2. 更新操作
UPDATE [dbo].[SalesOrderDetail]
SET Quantity = 10
WHERE OrderID = 1001 AND ProductID = 501;

-- 3. 删除操作
DELETE FROM [dbo].[SalesOrderDetail]
WHERE OrderID = 1002;

-- 4. 验证视图数据一致性
SELECT * FROM [dbo].[vOrderDetails];

-- 5. 尝试非法操作:修改基表列类型
-- ALTER TABLE [dbo].[SalesOrderDetail] ALTER COLUMN Quantity BIGINT; -- 错误
这段代码演示了在存在索引视图的情况下进行DML操作的过程。首先插入新记录,SQL Server会自动更新[vOrderDetails]的聚集索引。接着更新现有记录的Quantity,索引中的值也会相应调整。删除记录后,索引中对应的条目被移除。最后查询视图,确认数据与基表同步。尝试修改基表列类型的操作被阻止,证明了SCHEMABINDING的保护机制。这表明,虽然DML操作可以正常执行,但后台需要维护索引一致性,因此在高并发写入场景下需谨慎使用索引视图。

















