








在oracle中实现通用的递归存储过程遍历多级树状组织架构,核心做法是结合使用`connect by prior`子句进行层级查询,或者利用递归cte(common table expression)语法。对于需要执行复杂逻辑或返回动态结果集的通用场景,推荐使用基于游标的递归cte存储过程,因为它能更好地处理中间计算和异常分支。通过定义包含根节点识别、层级深度追踪以及路径记录的cte,可以灵活地向下钻取或向上回溯,同时利用临时表或集合类型收集遍历过程中的关键数据,从而满足各种复杂的组织分析需求。

如何构建支持任意深度的递归CTE结构
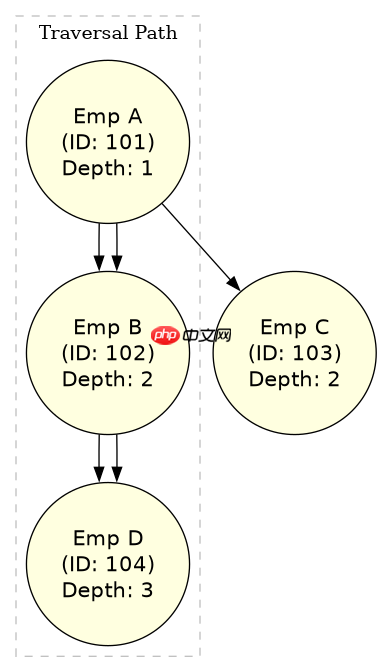
构建支持任意深度的递归CTE结构,关键在于正确设置初始查询以定位根节点,并在递归部分通过自连接将当前层级的员工ID映射到下一层级的父ID。这种结构天然支持无限层级的遍历,无需预先知道树的深度。通过添加层级计数器(LEVEL)和路径字符串,可以在单次查询中获取完整的拓扑信息。这种方法比传统的`CONNECT BY`更易于在现代SQL标准中移植,且逻辑更加清晰直观。
CREATE OR REPLACE PROCEDURE sp_traverse_org_recursive (
    p_start_emp_id IN employees.employee_id%TYPE,
    p_result_set OUT SYS_REFCURSOR
) AS
BEGIN
    OPEN p_result_set FOR
        WITH RECURSIVE org_tree AS (
            -- 初始部分:找到起始员工及其直接上级关系
            SELECT
                employee_id,
                manager_id,
                first_name,
                last_name,
                1 AS depth,
                TO_CHAR(employee_id) AS path
            FROM employees
            WHERE employee_id = p_start_emp_id

            UNION ALL

            -- 递归部分:查找下级员工
            SELECT
                e.employee_id,
                e.manager_id,
                e.first_name,
                e.last_name,
                ot.depth + 1,
                ot.path || ',' || TO_CHAR(e.employee_id)
            FROM employees e
            INNER JOIN org_tree ot ON e.manager_id = ot.employee_id
        )
        SELECT * FROM org_tree
        ORDER BY depth, employee_id;
END;
/
上述代码定义了一个名为`sp_traverse_org_recursive`的存储过程。它接受一个起始员工ID作为输入,并通过输出参数`SYS_REFCURSOR`返回结果集。CTE中的`org_tree`首先选取指定的起始员工,标记深度为1。随后,递归部分通过`UNION ALL`连接`employees`表,查找所有`manager_id`等于当前递归结果中`employee_id`的记录,并将深度加1。最终查询按深度排序,确保层级顺序正确。调用时只需传入具体的员工ID即可获取从该点开始的所有下属层级信息。
如何处理循环引用与死锁风险
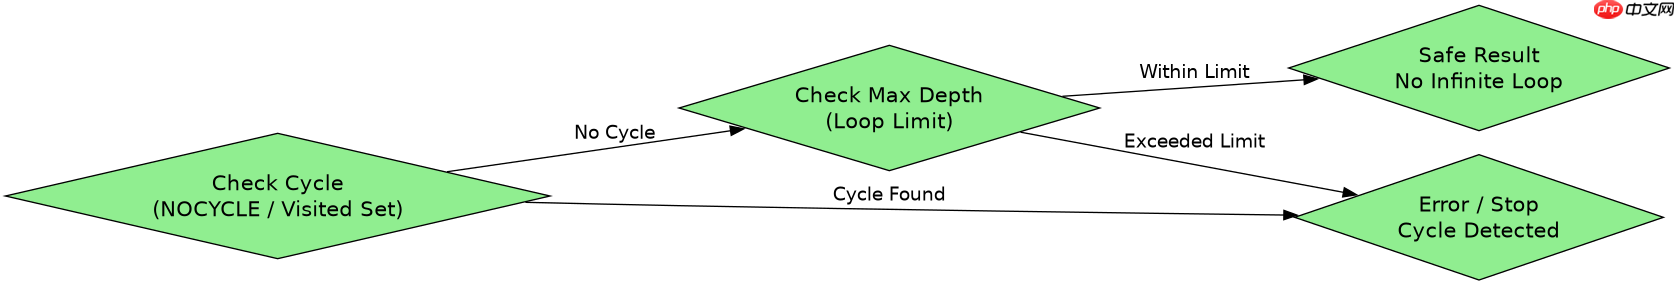
处理循环引用与死锁风险,需要在递归逻辑中加入访问状态检查或使用Oracle特有的`CONNECT_BY_ISCYCLE`功能。如果数据中存在错误的父子关系导致闭环,递归查询会报错或陷入无限循环。通过在CTE中维护一个已访问节点的集合,或者在`CONNECT BY`中使用`NOCYCLE`提示并配合`CONNECT_BY_ROOT`函数,可以有效拦截非法路径。此外,设置最大递归深度限制也是一种常见的防御性编程手段,防止因数据异常导致的资源耗尽。

-- 示例:使用 CONNECT BY NOCYCLE 处理潜在循环
SELECT
    employee_id,
    manager_id,
    LEVEL,
    SYS_CONNECT_BY_PATH(first_name, '/') AS path,
    CONNECT_BY_ISLEAF AS is_leaf,
    CONNECT_BY_ISCYCLE AS is_cycle
FROM employees
START WITH manager_id IS NULL
CONNECT BY PRIOR employee_id = manager_id
NOCYCLE;

-- 示例:在存储过程中加入深度限制
CREATE OR REPLACE PROCEDURE sp_safe_traverse_org (
    p_start_id IN NUMBER,
    p_max_depth IN NUMBER DEFAULT 10
) AS
    v_current_depth NUMBER := 1;
BEGIN
    -- 实际业务逻辑中,应在每次递归迭代前检查 v_current_depth
    -- 若超过 p_max_depth,则终止递归或抛出警告
    DBMS_OUTPUT.PUT_LINE('Starting traversal from ID: ' || p_start_id);
    -- 此处省略具体游标处理代码,重点在于逻辑控制
END;
/
在实际应用中,数据完整性往往难以保证绝对无误。使用`NOCYCLE`关键字可以让Oracle在检测到循环时自动停止该分支的遍历,并将`CONNECT_BY_ISCYCLE`标记为1,便于后续排查。而在自定义存储过程中,手动控制深度更为灵活。例如,在上面的`sp_safe_traverse_org`过程中,虽然未展示完整游标逻辑,但强调了在每次深入下一层之前检查当前深度是否超过预设阈值`p_max_depth`。这种显式的边界检查能有效避免极端情况下的性能问题或栈溢出错误,确保存储过程的健壮性。
如何根据特定部门条件过滤遍历结果
根据特定部门条件过滤遍历结果,可以在递归CTE的初始查询或递归步骤中加入额外的`WHERE`子句约束。例如,只遍历属于“IT部”的员工,或者只保留职级高于经理的人员。通过在递归的每一层都应用这些过滤条件,可以确保最终返回的结果集不仅符合层级结构,还严格满足业务筛选规则。这种方式避免了先获取全量数据再在应用层过滤的性能损耗,直接在数据库层面完成高效的数据裁剪。
假设我们需要遍历某位经理的所有下属,但仅关注那些职位为‘Developer’的员工。可以在递归部分的`JOIN`条件后追加过滤:
WITH RECURSIVE filtered_org AS (
    SELECT employee_id, manager_id, job_title, 1 AS depth
    FROM employees
    WHERE employee_id = :start_id

    UNION ALL

    SELECT e.employee_id, e.manager_id, e.job_title, fo.depth + 1
    FROM employees e
    JOIN filtered_org fo ON e.manager_id = fo.employee_id
    WHERE e.job_title = 'Developer'  -- 仅在递归层应用过滤
)
SELECT * FROM filtered_org;
注意,如果在初始部分也加上`job_title = 'Developer'`,那么起始员工如果不是开发者,结果集将为空。因此,通常建议在递归部分应用过滤,以保持起始点的可见性,除非业务明确要求起始点也必须符合条件。这种细粒度的控制使得存储过程能够适应多种多样的报表和分析需求,而无需修改底层数据结构。



















