








在sql中避免lead函数在宽表扫描时的严重性能损耗,核心策略是放弃全表扫描式的窗口计算,转而使用基于主键或唯一索引的等值连接(join)来直接定位目标行。具体做法是将原表自连接,通过偏移量计算目标行的主键值,利用数据库的索引快速查找替代逐行扫描。这样做可以将时间复杂度从o(n)降低到o(logn),从而显著减少i/o开销和cpu消耗。
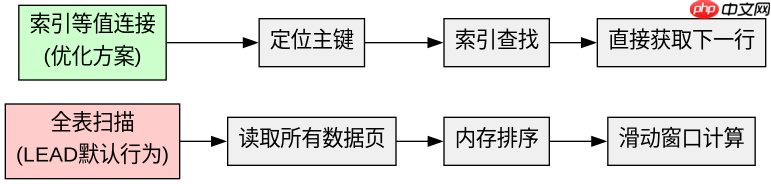
为什么LEAD会导致全表扫描
LEAD函数属于窗口函数,其执行逻辑要求数据库引擎对结果集进行排序并维护一个滑动窗口状态。对于宽表而言,这意味着需要读取所有数据页,并在内存或临时磁盘空间中构建完整的排序结构。即使存在索引,如果查询涉及大量非索引列或无法覆盖索引,优化器仍可能选择全表扫描以获取所需的所有列数据,导致严重的性能瓶颈。
SELECT
    t1.id,
    t1.value AS current_value,
    t2.value AS next_value
FROM my_table t1
LEFT JOIN my_table t2
    ON t1.id = t2.id - 1
WHERE t1.id IN (SELECT id FROM my_table ORDER BY id LIMIT 1000);
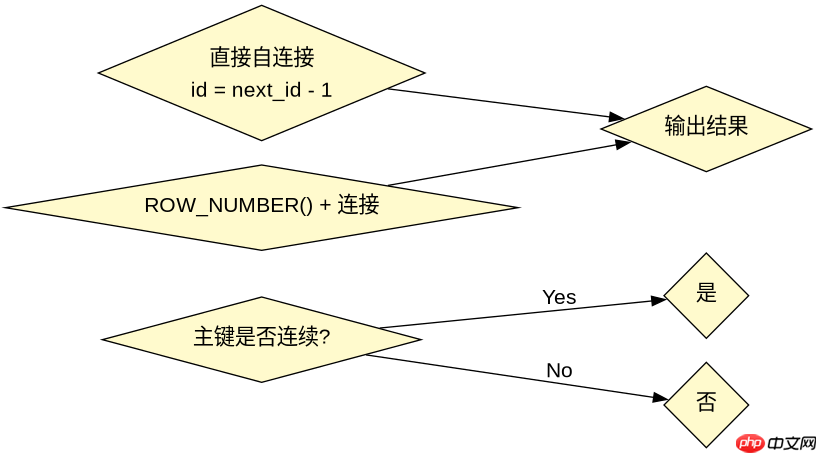
上述代码展示了如何通过自连接实现LEAD的效果。假设my_table有一个自增的主键id,我们直接通过id-1找到下一行。这种写法利用了主键索引,避免了全表扫描。预期结果是只返回指定范围内的前1000条记录及其下一行的值,且执行计划显示为Index Seek而非Table Scan。
如何优化大表的窗口函数执行
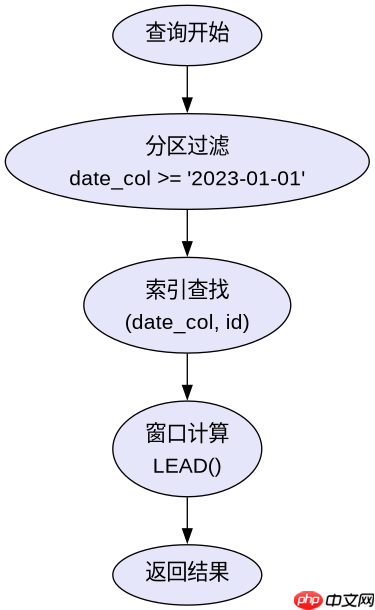
当必须使用窗口函数时,可以通过分区裁剪和索引覆盖来优化。将数据按时间或业务ID分区,并在查询中明确指定分区条件,可以大幅减少扫描的数据量。同时,确保窗口函数的排序列和分区列都在索引中,可以避免额外的排序操作。
SELECT
    id,
    value,
    LEAD(value) OVER (PARTITION BY date_col ORDER BY id) AS next_value
FROM my_table
WHERE date_col >= '2023-01-01' AND date_col < '2023-02-01';
这段代码通过date_col进行分区裁剪,限制了扫描范围。如果date_col和id上有复合索引,数据库可以直接利用索引进行排序和取值,无需额外排序。预期结果是仅扫描2023年1月的数据,并利用索引高效计算LEAD值。
基于特定输入条件的性能对比
当表中存在大量重复值或稀疏主键时,自连接方法可能失效。此时,应结合ROW_NUMBER()生成连续序号,再基于序号进行连接。这种方法适用于主键不连续的场景,能确保准确获取下一行数据。



















