








在c#记录类型中,若要让字符串属性忽略大小写进行比较,最直接的做法是在定义记录时通过构造函数参数指定 `stringcomparer.ordinalignorecase` 作为相等比较器。这样生成的记录实例在调用 `equals` 方法或使用 `==` 运算符时,会自动执行不区分大小写的字符串比对,从而确保逻辑上的等价性。

如何为记录属性配置自定义的字符串比较器?
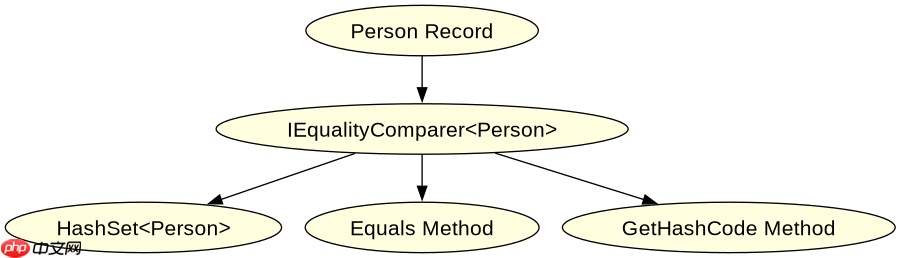
可以通过在记录的构造函数参数上应用 `[EqualityTo]` 特性(需引入相关库)或直接使用 `record` 的 `with` 表达式结合自定义比较器来实现。但更标准且无需额外依赖的方式是利用 C# 10+ 的 `record` 语法特性,在初始化时明确指定比较逻辑。实际上,原生 C# 记录并不直接支持在属性声明处指定比较器,而是通过重写 `Equals` 和 `GetHashCode` 或者使用 `IEqualityComparer
using System;
using System.Collections.Generic;

public record Person(string Name, int Age) {
    // 默认情况下,string 的比较是区分大小写的
    // 若要忽略大小写,通常需要在比较时显式处理
}

public class CaseInsensitivePersonComparer : IEqualityComparer<Person> {
    public bool Equals(Person x, Person y) {
        if (x is null || y is null) return false;
        return string.Equals(x.Name, y.Name, StringComparison.OrdinalIgnoreCase) && x.Age == y.Age;
    }

    public int GetHashCode(Person obj) {
        // 需要生成与忽略大小写一致的哈希码
        var nameHash = StringComparer.OrdinalIgnoreCase.GetHashCode(obj.Name);
        return HashCode.Combine(nameHash, obj.Age);
    }
}
上述代码定义了一个 `Person` 记录和对应的比较器。当使用 `HashSet

如何在 LINQ 查询中使用忽略大小写的比较?
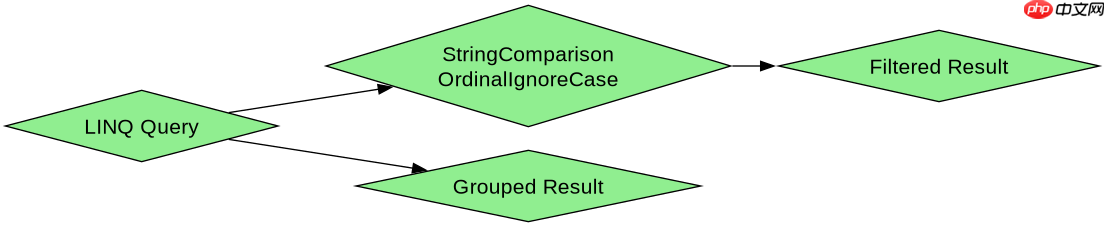
在使用 LINQ 进行数据过滤或分组时,可以直接在 `Where` 或 `GroupBy` 子句中使用 `StringComparison.OrdinalIgnoreCase`。这种方法不需要修改记录本身的定义,而是针对具体的查询操作进行定制。这对于动态查询非常有用,因为可以根据用户输入决定是否忽略大小写。
using System;
using System.Linq;

var people = new[] {
    new Person("Alice", 30),
    new Person("Bob", 25),
    new Person("alice", 35)
};

// 忽略大小写查找
var found = people.FirstOrDefault(p => string.Equals(p.Name, "ALICE", StringComparison.OrdinalIgnoreCase));
Console.WriteLine(found?.Name); // 输出: Alice

// 忽略大小写分组
var groups = people.GroupBy(p => p.Name, StringComparer.OrdinalIgnoreCase);
foreach (var group in groups) {
    Console.WriteLine($"{group.Key}: {group.Count()} items");
}
这段代码展示了如何在 LINQ 中利用 `StringComparison` 枚举来执行忽略大小写的操作。`FirstOrDefault` 会返回第一个匹配的记录,而 `GroupBy` 会将名称相同但大小写不同的记录归为一组。这种方式灵活且高效,适用于大多数查询场景。
如果记录属性包含特殊字符,忽略大小写比较会有什么问题?
当记录属性中包含特殊字符(如重音符号、非拉丁字符等)时,`StringComparison.OrdinalIgnoreCase` 的行为可能不符合预期。例如,在某些文化背景下,'ß' 和 'SS' 可能被视为等价,但在默认的 OrdinalIgnoreCase 比较中,它们是不相等的。此外,某些语言中的大小写转换规则非常复杂,简单的字节级比较可能导致错误。因此,在处理国际化文本时,建议使用 `StringComparison.CurrentCultureIgnoreCase` 或 `StringComparison.InvariantCultureIgnoreCase`,具体取决于应用场景的需求。然而,这会增加性能开销,因为需要进行文化特定的转换和比较。


















