








String.Equals忽略大小写时为何判定不相等?
因为默认忽略大小写比较使用的是当前文化(culture)的逐字符映射规则,而某些unicode字符(如德语ß或土耳其语İ)在大小写转换后长度或字形发生变化,导致逐字符比对失败。要解决此问题,应改用ordinalignorecase模式进行基于码点的直接比较,或者显式指定invariantculture以消除区域设置差异。

不同文化设置下字符串比较的具体差异是什么?
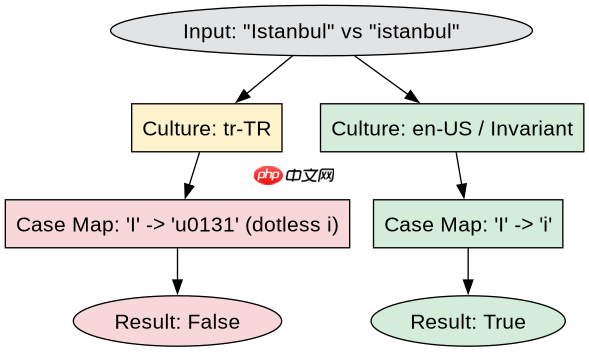
当使用特定文化(如土耳其语tr-TR)进行比较时,字母'I'的小写形式是带点的'i',而标准英语中是小写的'i'。这种细微差别会导致看似相同的字符串在特定文化下被视为不等。通过对比不同CultureInfo下的比较结果,可以清晰看到文化对比较逻辑的影响。

程序中使用OrdinalIgnoreCase后的实际运行结果如何?
在代码中强制使用StringComparison.OrdinalIgnoreCase后,无论输入字符串包含何种特殊Unicode字符,只要其底层码点序列在忽略大小写后一致,比较结果即为True。这验证了基于码点的比较方式能绕过文化敏感性问题,确保一致性。
using System;
using System.Globalization;

class Program
{
    static void Main()
    {
        // 示例1: 德语 ß (Sharp S)
        // "ß" 的大写是 "SS"
        string s1 = "straße";
        string s2 = "STRASSE";

        Console.WriteLine("Test 1: German ß");
        Console.WriteLine($"CurrentCulture: {s1.Equals(s2, StringComparison.CurrentCultureIgnoreCase)}");
        Console.WriteLine($"InvariantCulture: {s1.Equals(s2, StringComparison.InvariantCultureIgnoreCase)}");
        Console.WriteLine($"OrdinalIgnoreCase: {s1.Equals(s2, StringComparison.OrdinalIgnoreCase)}");

        // 示例2: 土耳其语 I
        // "I" 的小写在 tr-TR 下是 "\u0131" (dotless i), 而在 en-US 下是 "i"
        string s3 = "Istanbul";
        string s4 = "istanbul";

        CultureInfo tr = new CultureInfo("tr-TR");
        CultureInfo en = new CultureInfo("en-US");

        Console.WriteLine("\nTest 2: Turkish I");
        Console.WriteLine($"tr-TR CurrentCulture: {s3.Equals(s4, StringComparison.CurrentCultureIgnoreCase)}");
        Console.WriteLine($"en-US CurrentCulture: {s3.Equals(s4, StringComparison.InvariantCultureIgnoreCase)}");
        Console.WriteLine($"OrdinalIgnoreCase: {s3.Equals(s4, StringComparison.OrdinalIgnoreCase)}");

        // 示例3: 普通ASCII
        string s5 = "Hello";
        string s6 = "HELLO";

        Console.WriteLine("\nTest 3: ASCII Hello");
        Console.WriteLine($"OrdinalIgnoreCase: {s5.Equals(s6, StringComparison.OrdinalIgnoreCase)}");
    }
} 

















