


做跨表动态计算不用硬写复杂嵌套,其实可以拆成两步走:先在明细表把所有要算的结果批量自动铺开,再去汇总表把需要的数值精准捞到目标位置。前半部分用arrayformula这类支持批量溢出的数组公式处理最顺手,后半部分直接用getpivotdata按字段条件从数据透视表里取数就行,这么搭出来的明细和汇总联动稳定性会高很多。

先把明细表里的批量结果铺开,不要一行一行复制公式
做跨表计算最头疼的从来不是公式难,而是每次新加几行数据,都得手动往下拖公式补行。稳当的做法是先在明细表这边,把所有要用到的运算逻辑做成能自动扩展的数组公式,结果列跟着原始数据的增减自动更新就行。后面不管是汇总表、透视表还是看板,拿到的都是一整列提前算好的结果,根本不用再手动补拖公式。
要是你手头的工作簿本来就堆了好几个来源表,比如销售明细表、产品表、门店表,先把所有基础计算都统一放在明细区做完,后面跨表引用会干净清爽很多。不然每张表各算各的,哪天改个字段名,整套引用链路直接断得莫名其妙。
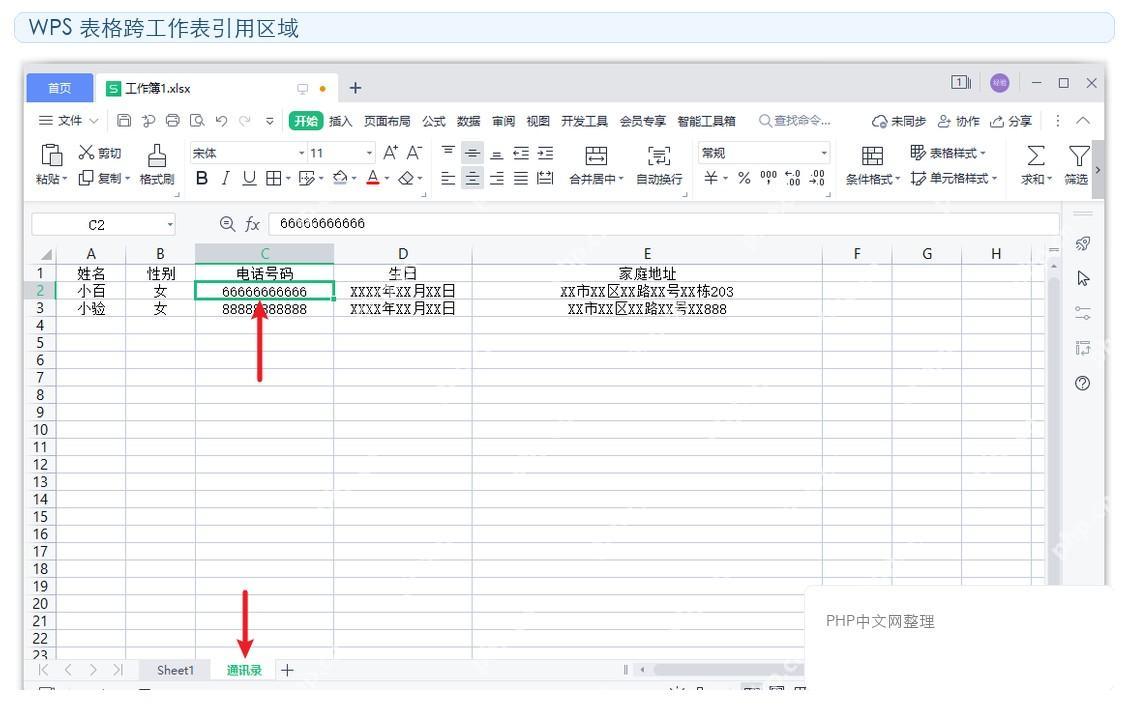
跨表引用前先把目标区域和来源区域理顺
动手写公式之前,先把分工捋清楚:哪张表放原始数据,哪张表存中间计算结果,哪张表专门用来做汇总展示。跨表动态计算最容易踩的坑,就是一开始没把引用区域分明白。先把来源表、结果表、汇总表这三层关系理顺,后面不管是做数组扩展还是透视取数,维护起来都省心。
多人协同共用的工作簿尤其要注意,尽量把所有跨表引用都集中在固定区域,别东写一块西写一块散得到处都是。后面排查问题的时候,扫一眼就能看明白当前单元格是在引明细、引中间结果,还是直接引透视汇总,效率高很多。
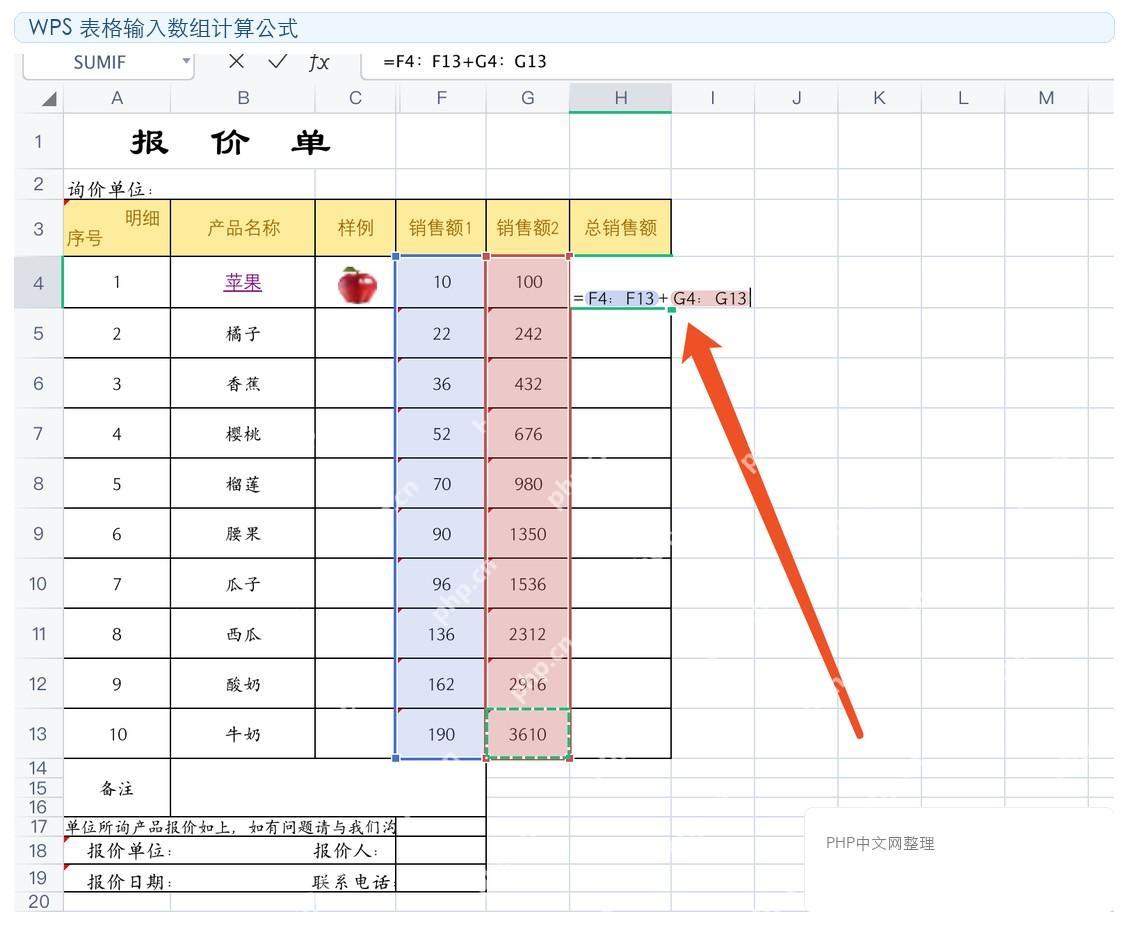
把批量扩展结果先算出来,再交给汇总层使用
确认好所有来源列之后,先把数量、单价、销售额、分类编号这些后续要反复用到的字段全部批量算完。这一步核心不是纠结用哪个具体函数,重点是让算出来的结果列具备自动扩展能力。只要底层结果列稳了,后面做透视表汇总、跨表引用甚至二次分析,都能省掉一大堆重复干活的时间。
这层算完顺手查一遍,看看有没有空值、文本和数字混存、引错列这类小问题。要是带着脏数据去做透视表,后面用GETPIVOTDATA取出来的数乍一看没问题,其实早把错误值一起算进总和里了,很难查。

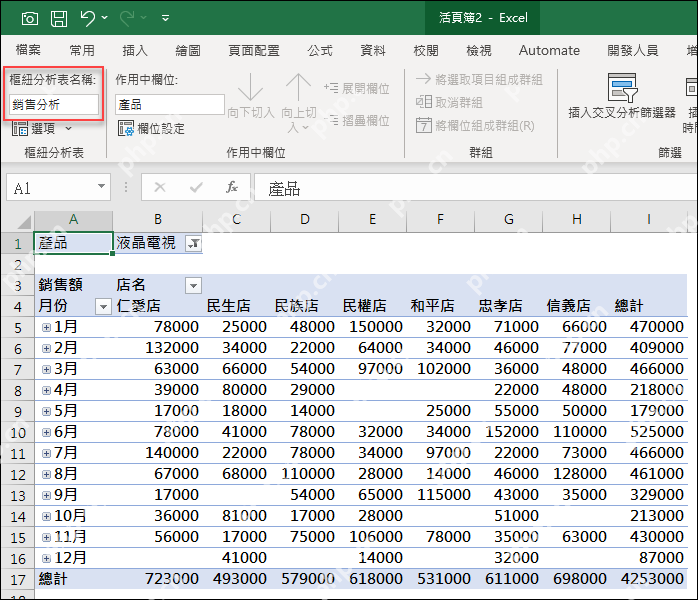
把需要跨表调用的汇总结果先做成数据透视表
明细层全部准备好之后,别急着直接手写一大堆跨表求和公式,先把核心指标都放进数据透视表里。比如按月份、门店、产品、业务员维度汇总销售额,先让透视表把所有维度的对应关系整理好。后面你要捞「某月某店某产品」的数值,直接按字段条件提取就行,不用自己吭哧吭哧写一长串筛选求和逻辑。
这一步本质就是把「计算逻辑」丢给透视表,把「取数逻辑」留给GETPIVOTDATA。两层分工划清楚,搭出来的跨表模型,比你硬堆一大堆SUMIFS或者手写引用要稳得多。
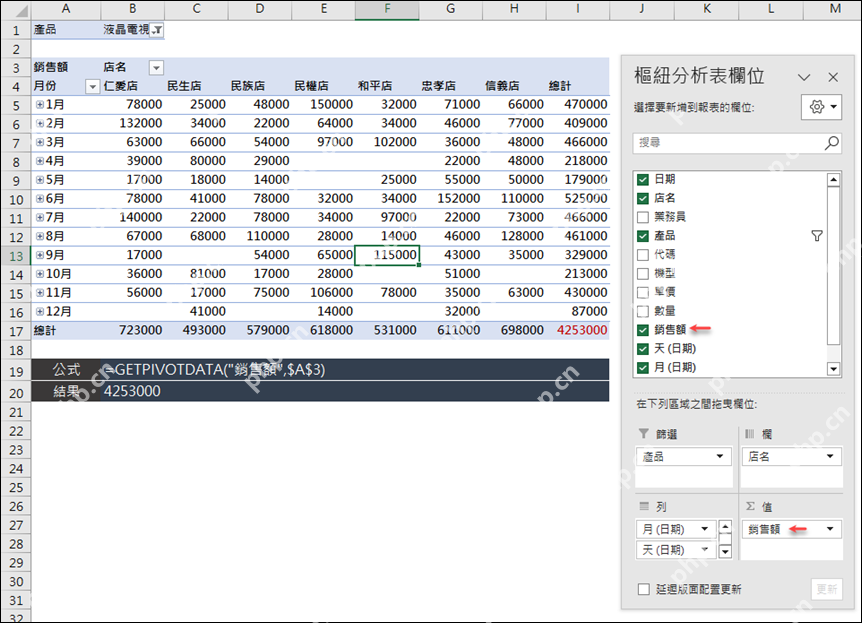
先用 GETPIVOTDATA 抓总值,再确认字段名没有写错
刚用GETPIVOTDATA的时候,先别急着加一堆条件,第一步先把透视表里的总值或者某个核心字段的结果捞回来。先验证下你当前选的透视表、值字段名、锚点单元格有没有写错。要是连最基础的总值都取不出来,后面再加门店、月份、日期这类条件,排查问题只会更费劲。
实际操作的时候,建议先写个最简单的版本,比如只取「销售额总计」,确认公式返回结果正常,再一步步加门店、月份、日期这些筛选条件。一层一层叠参数,定位错误速度快很多。
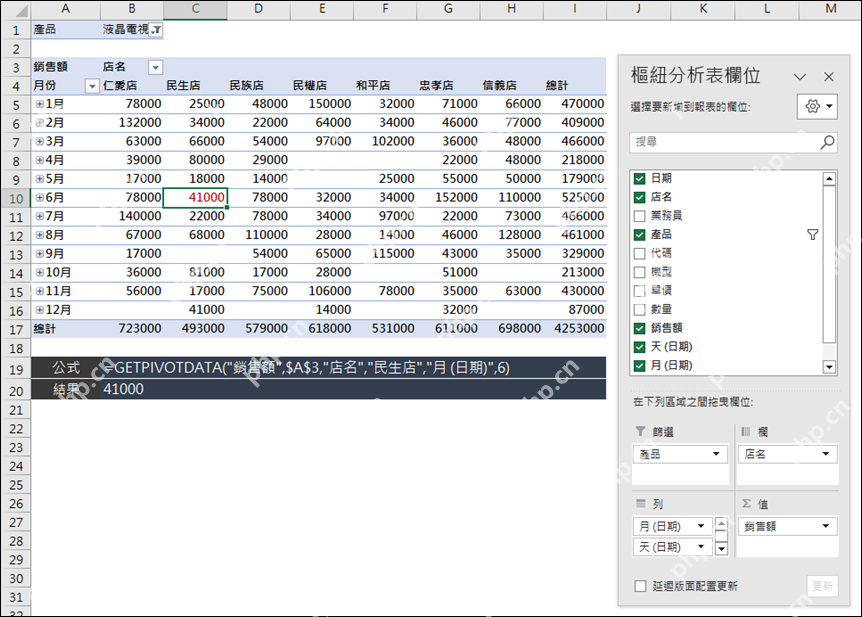
再叠加门店和月份条件,跨表动态取数才真正成型
基础取数跑通之后,再慢慢把门店、月份、日期这类条件加进去,GETPIVOTDATA的优势才真正发挥出来。它不是死板地把透视表里某一个格子的数值抄过来,而是按照字段名和你给的条件组合,去匹配对应的结果。只要透视表的结构不变,你在其他工作表里随时都能稳定调用需要的汇总值,不会因为透视表的行列位置挪动就直接报错失效。
把这套逻辑和前面说的批量自动扩展的明细结果结合起来,跨表动态计算跑起来会特别顺:底层明细靠数组公式自动铺开更新,中层透视表负责按维度聚合数据,顶层要做汇总的工作表再用GETPIVOTDATA按条件回填数值。后面不管是新加原始数据、切换统计月份,还是换个维度按门店统计,整条计算链路都比传统的手动写引用省心太多。













