








在 java 单元测试中集成性能测试,核心做法是利用 jmh(java microbenchmark harness)对关键方法进行微基准测试,通过隔离环境获取精确的执行耗时数据。具体操作是创建专门的 benchmark 类,使用 @benchmarkmode 指定测试模式(如吞吐量或平均时间),并通过 @warmup 和 @measurement 控制预热与测量轮次,从而发现代码中的 cpu 密集型瓶颈或锁竞争问题。
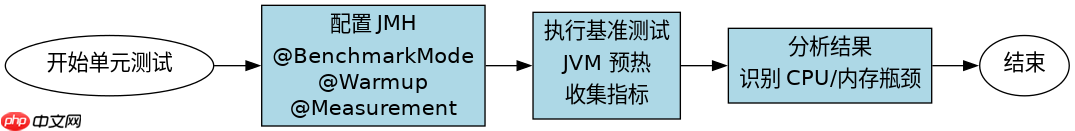
JMH 基准测试如何配置以隔离 JVM 干扰
JMH 通过强制预热和多次迭代来消除 JIT 编译和垃圾回收带来的噪声,确保测试结果反映真实性能。配置时需明确指定 BenchmarkMode 为 AverageTime 以关注单次调用耗时,并设置足够的 warmupIterations 让热点代码进入稳定状态。这种配置能直接定位到方法内部的执行效率,而非系统整体负载。
import org.openjdk.jmh.annotations.*;
import org.openjdk.jmh.runner.Runner;
import org.openjdk.jmh.runner.options.Options;
import org.openjdk.jmh.runner.options.OptionsBuilder;
import java.util.concurrent.TimeUnit;

@State(Scope.Thread)
public class StringConcatBenchmark {
    @Benchmark
    @BenchmarkMode(Mode.AverageTime)
    @OutputTimeUnit(TimeUnit.NANOSECONDS)
    @Warmup(iterations = 5, time = 1)
    @Measurement(iterations = 10, time = 1)
    public void testStringConcat() {
        StringBuilder sb = new StringBuilder();
        for (int i = 0; i < 100; i++) {
            sb.append("test");
        }
    }

    public static void main(String[] args) throws Exception {
        Options opt = new OptionsBuilder()
                .include(StringConcatBenchmark.class.getSimpleName())
                .forks(1)
                .build();
        new Runner(opt).run();
    }
}
上述代码定义了针对字符串拼接的微基准测试。运行后,JMH 会输出类似 AverageTime: 45.234 ns/op 的结果,该数值即为单次操作的平均耗时,开发者可据此判断是否达到预期性能指标。
立即学习“Java免费学习笔记(深入)”;

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
如何通过参数化输入验证不同数据规模下的性能差异
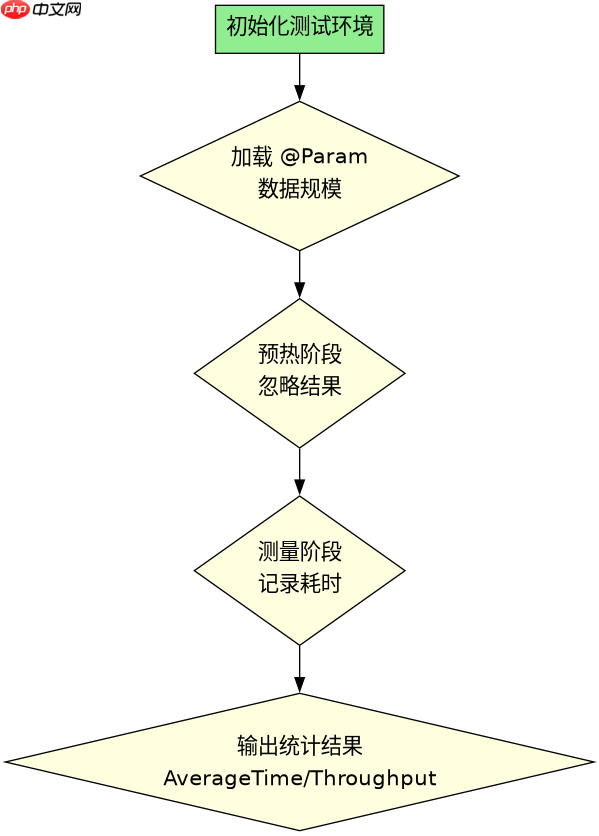
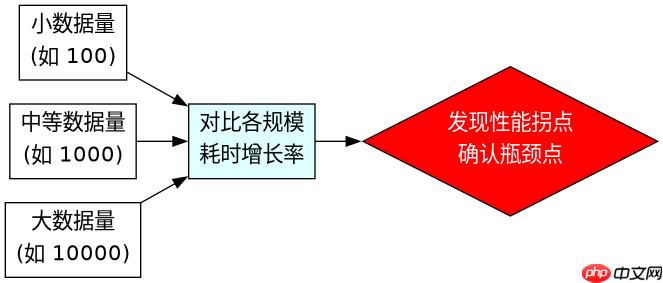
为了发现特定数据量下的性能拐点,应使用 @Param 注解对基准测试方法进行参数化,模拟不同规模的输入数据。这种方法能直观展示算法复杂度随输入增长的变化趋势,帮助识别内存分配峰值或循环效率低下的节点。通过对比不同参数下的耗时,可以确定最优的数据处理阈值。
import org.openjdk.jmh.annotations.*;
import org.openjdk.jmh.runner.Runner;
import org.openjdk.jmh.runner.options.Options;
import org.openjdk.jmh.runner.options.OptionsBuilder;
import java.util.ArrayList;
import java.util.List;

@State(Scope.Thread)
public class ListSortBenchmark {
    @Param({"100", "1000", "10000"})
    private int size;
    private List<Integer> list;

    @Setup
    public void setup() {
        list = new ArrayList<>(size);
        for (int i = 0; i < size; i++) {
            list.add((int) (Math.random() * 1000));
        }
    }

    @Benchmark
    public void testSort() {
        list.sort(null);
    }

    public static void main(String[] args) throws Exception {
        Options opt = new OptionsBuilder()
                .include(ListSortBenchmark.class.getSimpleName())
                .forks(1)
                .build();
        new Runner(opt).run();
    }
}
运行此程序将分别输出大小为 100、1000 和 10000 时的排序耗时。若发现从 1000 到 10000 耗时呈非线性急剧上升,则提示当前排序算法或数据结构在处理大规模数据时存在瓶颈,需考虑优化策略。
当基准测试显示高 CPU 占用时如何定位具体热点方法
如果基准测试结果显示某方法耗时显著高于预期且伴随高 CPU 占用,通常意味着该方法内部存在复杂计算或频繁的对象创建。此时应结合 Async-Profiler 或 IDE 的性能分析器,挂载到正在运行的 JMH 进程上,生成火焰图。火焰图能直观展示调用栈中各方法的 CPU 时间占比,从而精准定位到具体的代码行或子方法,而非仅仅停留在宏观的基准测试层面。



















