








使用 java 流式处理避免内存溢出的核心做法是放弃一次性加载整个文件到内存,改为通过 bufferedreader 或 files.lines() 按行读取,或者使用 inputstream 配合固定大小的缓冲区进行分块读写。对于大文件,推荐在 try-with-resources 中显式管理流的生命周期,确保资源及时释放;若需处理超大文本,应利用 stream api 的惰性求值特性,仅在需要时触发计算并立即丢弃中间结果,从而将内存占用控制在常数级别。
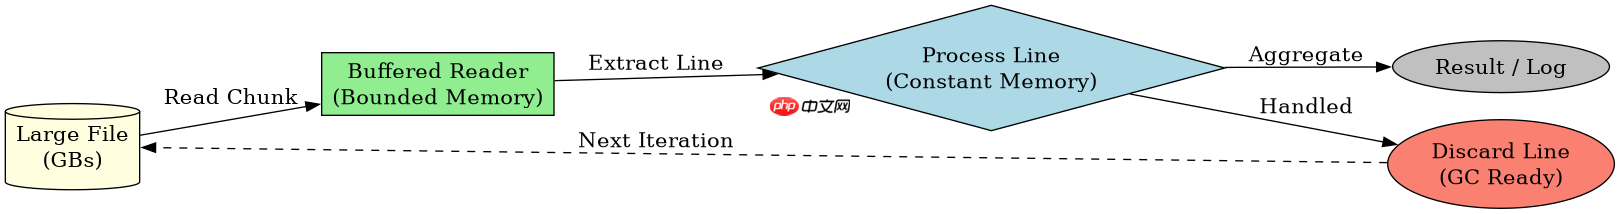
如何逐行读取大文本文件而不撑爆堆内存
直接回答:使用 java.nio.file.Files.newBufferedReader 配合 try-with-resources 语句,可以安全地逐行遍历大文件。这种方法底层基于缓冲机制,每次只从磁盘读取少量数据到内存缓冲区,处理完一行后立即释放该行引用,使得内存峰值仅与单行长度及缓冲区大小相关,而非文件总大小。关键在于不要将每一行存入集合(如 List),而是直接在循环中进行聚合或写入操作。
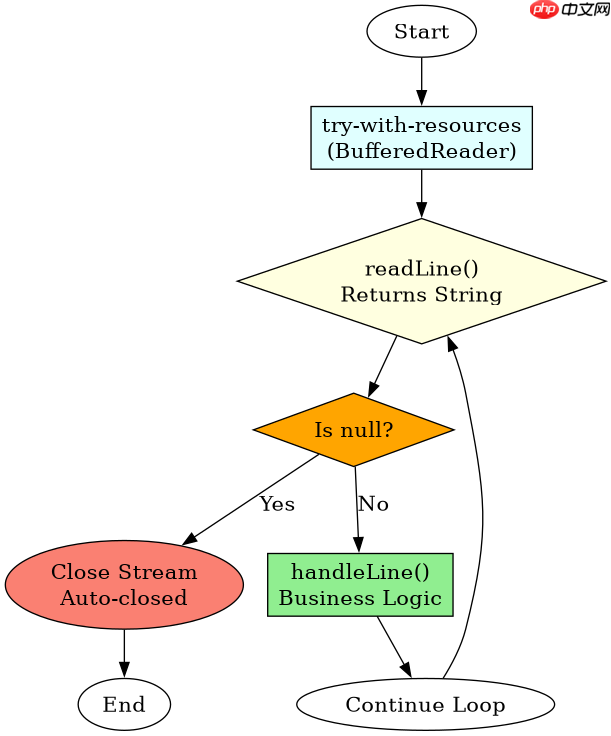
import java.io.BufferedReader;
import java.io.IOException;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;

public class LineByLineReader {
    public static void processLargeFile(Path filePath) throws IOException {
        // 使用 try-with-resources 自动关闭流,防止资源泄漏
        try (BufferedReader reader = Files.newBufferedReader(filePath, StandardCharsets.UTF_8)) {
            String line;
            // readLine() 每次只返回一行字符串,不会加载整个文件
            while ((line = reader.readLine()) != null) {
                // 在这里处理每一行,例如过滤、转换或累加
                // 处理完后,line 引用被覆盖,旧行对象可被 GC 回收
                handleLine(line);
            }
        }
    }

    private static void handleLine(String line) {
        // 模拟业务逻辑
        if (line.contains("ERROR")) {
            System.out.println("Found error: " + line);
        }
    }
}
预期结果:程序能够处理 GB 级别的日志文件,而 JVM 堆内存使用率保持平稳,不会出现 OutOfMemoryError。每行数据在处理完毕后即失去强引用,垃圾回收器会适时清理。
立即学习“Java免费学习笔记(深入)”;

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
如何使用 Stream API 实现惰性的大文件数据处理
直接回答:调用 Files.lines(Path) 获取一个 Stream<string></string>,并结合终端操作(如 filter, map, collect)进行链式处理。Stream 的惰性求值特性意味着只有当调用终端操作时才会开始读取数据,且中间操作不会创建新的集合来存储所有元素,而是像流水线一样逐个处理元素。这进一步降低了内存开销,并允许更函数式的代码风格。注意 Files.lines() 同样实现了 AutoCloseable,必须关闭。

import java.io.IOException;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.stream.Stream;

public class StreamFileProcessor {
    public static long countErrors(Path filePath) throws IOException {
        // Files.lines 返回一个 Stream,默认 UTF-8 编码
        try (Stream<String> lines = Files.lines(filePath, StandardCharsets.UTF_8)) {
            // filter 和 count 都是惰性操作,不会一次性加载所有行
            return lines
                    .filter(line -> line.contains("CRITICAL"))
                    .count();
        }
    }
}
预期结果:count 操作会遍历整个流,但内存中始终只保留当前正在处理的这一行字符串以及必要的迭代器状态。即使文件有数百万行,内存占用也极低。如果中途发生异常,流会自动关闭。
当文件包含超长行或特殊分隔符时流式处理会遇到什么问题
直接回答:当文件中存在极长的一行(例如没有换行符的巨型 JSON 或 CSV 记录)时,BufferedReader.readLine() 或 Files.lines() 会将整行内容作为一个巨大的 String 对象加载到内存中,这依然可能导致内存溢出。此外,如果分隔符不是标准的换行符,默认的流式接口无法正确切分数据。解决思路是改用 InputStream 配合自定义的分块解析逻辑,或者使用专门处理大文件的库(如 OpenCSV 的大文件模式),手动管理字节缓冲区而非依赖行分割。



















