








使用 preparedstatement 执行批量数据索引的核心做法是调用 addbatch() 方法将多条 sql 语句加入队列,随后调用 executebatch() 一次性提交。这样做可以显著减少网络往返次数并提高数据库处理效率。需要注意的是,必须在执行前关闭自动提交模式(autocommit=false),否则每次操作都会立即生效,失去批量优势。

如何配置连接以支持批量操作
要实现批量操作,必须显式设置 Connection 的自动提交属性为 false。默认情况下,JDBC 驱动会在每条语句执行后自动提交事务,这会导致 addBatch() 失效或性能极差。通过 setAutoCommit(false),可以将多条语句暂存在客户端缓冲区,直到调用 executeBatch() 时才统一发送给数据库。
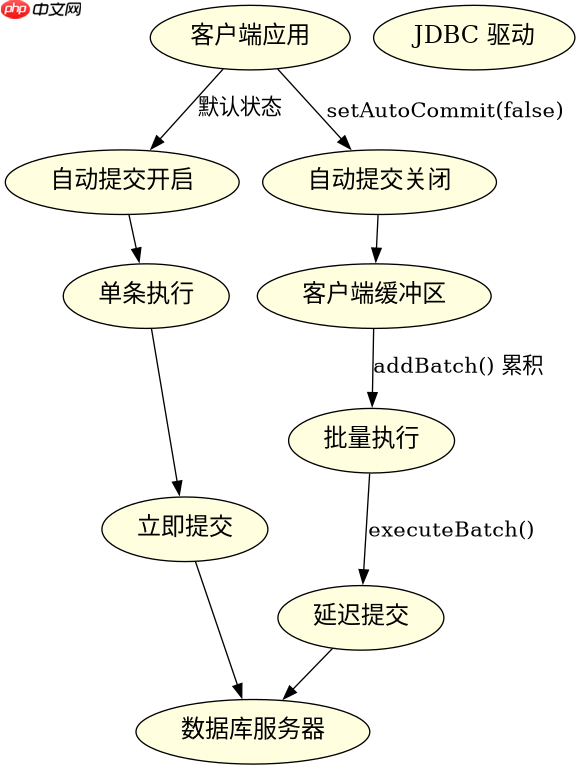
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 关键步骤:关闭自动提交
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, age) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < 100; i++) {
                    pstmt.setString(1, "User" + i);
                    pstmt.setInt(2, 20 + i);
                    pstmt.addBatch();
                }
                int[] results = pstmt.executeBatch();
                conn.commit(); // 手动提交事务
                System.out.println("Inserted rows: " + results.length);
            } catch (Exception e) {
                conn.rollback(); // 出错回滚
                e.printStackTrace();
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了完整的流程:获取连接、关闭自动提交、准备语句、循环添加参数和批次、执行批量更新、最后提交事务。如果中间出现异常,会触发回滚,保证数据一致性。
立即学习“Java免费学习笔记(深入)”;

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
如何处理批量执行中的异常与返回值
executeBatch() 返回一个 int[] 数组,每个元素表示对应语句的执行结果。成功插入或删除的行数通常为正整数,而 -2 表示受影响的行数未知,-3 表示语句无法执行。在实际开发中,应检查该数组以确认哪些语句成功、哪些失败。此外,某些数据库驱动(如 MySQL)在遇到错误时会抛出 BatchUpdateException,此时可以通过 getUpdateCounts() 获取部分成功的结果。

import java.sql.BatchUpdateException;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchErrorHandling {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "INSERT INTO users (name, age) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < 5; i++) {
                    pstmt.setString(1, "User" + i);
                    pstmt.setInt(2, 20 + i);
                    pstmt.addBatch();
                }
                // 故意制造错误:第3条数据年龄为负数,假设表有约束
                pstmt.setString(1, "Invalid");
                pstmt.setInt(2, -1);
                pstmt.addBatch();

                try {
                    int[] results = pstmt.executeBatch();
                    conn.commit();
                    for (int i = 0; i < results.length; i++) {
                        System.out.println("Row " + i + " result: " + results[i]);
                    }
                } catch (BatchUpdateException e) {
                    System.out.println("Batch failed at index: " + e.getIndex());
                    int[] counts = e.getUpdateCounts();
                    for (int i = 0; i < counts.length; i++) {
                        System.out.println("Row " + i + " status: " + counts[i]);
                    }
                    conn.rollback();
                }
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}此示例演示了如何在批量操作中捕获异常并分析部分成功的情况。当某条语句违反数据库约束时,executeBatch() 会抛出 BatchUpdateException,开发者可通过 getIndex() 定位失败位置,并通过 getUpdateCounts() 查看已成功执行的语句数量。这种机制允许程序在部分失败的情况下继续处理或进行精细化的错误恢复。
批量大小对性能的影响及优化建议
批量操作的性能并非随批次增大而线性提升,过大的批次可能导致内存溢出或数据库锁竞争。一般建议将每批次的语句数量控制在 100 到 1000 之间,具体取决于数据量和数据库配置。对于超大体量数据,可采用分块提交策略,即每处理 N 条记录后提交一次事务,既保证性能又避免长事务带来的资源占用。此外,启用 JDBC 驱动的批量优化选项(如 MySQL 的 rewriteBatchedStatements=true)可进一步加速执行。


















