








java 中通过 synchronized 实现锁分段的核心做法是:将一个大对象拆分为多个独立的子段(segment),每个子段拥有自己的独占锁,从而让不同线程访问不同段时互不阻塞。具体而言,需要定义一个包含多个内部锁对象的容器类,并在读写操作前仅对目标段对应的锁对象加锁,这样既保留了 synchronized 的语义,又显著提升了并发吞吐量。
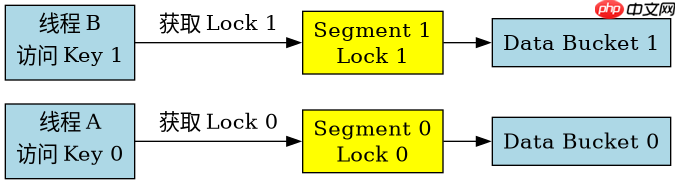
如何设计支持多锁的容器结构
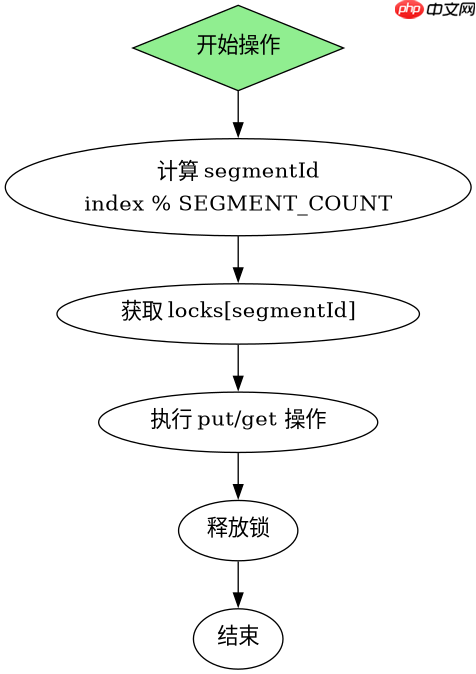
要实现锁分段,必须打破“一个对象一把锁”的传统模式,转而采用组合模式。核心思路是将数据划分为 N 个桶(Bucket),并为每个桶分配一个独立的 Object 实例作为锁。在代码实现上,通常使用数组或列表来存储这些锁对象和数据对象。当线程请求访问某个数据项时,先计算其所属的桶索引,然后只对该索引对应的锁对象执行 synchronized 块。这种设计使得只要两个线程操作的键值落在不同的桶中,它们的执行就是完全并行的,不会发生竞争。
import java.util.concurrent.locks.ReentrantLock;

public class SegmentedMap {
    private static final int SEGMENT_COUNT = 4;
    private final Object[] locks = new Object[SEGMENT_COUNT];
    private final String[][] data = new String[SEGMENT_COUNT][10];

    public SegmentedMap() {
        for (int i = 0; i < SEGMENT_COUNT; i++) {
            locks[i] = new Object(); // 每个段独立锁
        }
    }

    public void put(int index, String value) {
        int segmentId = Math.abs(index % SEGMENT_COUNT);
        synchronized (locks[segmentId]) { // 仅锁住当前段
            data[segmentId][index % 10] = value;
        }
    }

    public String get(int index) {
        int segmentId = Math.abs(index % SEGMENT_COUNT);
        synchronized (locks[segmentId]) {
            return data[segmentId][index % 10];
        }
    }
}
上述代码展示了最基础的锁分段实现。关键点在于 locks 数组的初始化,它为每个逻辑段提供了独立的监视器。在 put 和 get 方法中,通过取模运算确定目标段,随后进入该段的同步块。如果线程 A 操作索引 0(属于段 0),而线程 B 操作索引 1(属于段 1),两者将同时进入各自的 synchronized 块,互不等待。这直接解决了全局锁导致的串行化问题。
立即学习“Java免费学习笔记(深入)”;

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
锁分段在实际哈希表中的冲突处理
在真实的并发哈希表(如 Java 7 的 ConcurrentHashMap)中,锁分段不仅用于隔离数据,还用于处理哈希冲突。当多个键映射到同一个桶时,它们共享同一把锁;但当它们映射到不同桶时,则并行执行。为了验证这一行为,我们需要观察当输入键分布均匀与分布集中时的锁竞争情况。如果所有键都映射到同一个段,锁分段退化为全局锁,性能下降;如果键均匀分布,并发度达到最大。
public class StressTest {
    public static void main(String[] args) throws InterruptedException {
        SegmentedMap map = new SegmentedMap();
        Thread t1 = new Thread(() -> {
            for (int i = 0; i < 100; i++) map.put(0, "val"); // 段 0
        });
        Thread t2 = new Thread(() -> {
            for (int i = 0; i < 100; i++) map.put(1, "val"); // 段 1
        });
        long start = System.currentTimeMillis();
        t1.start(); t2.start();
        t1.join(); t2.join();
        System.out.println("Time: " + (System.currentTimeMillis() - start));
    }
}
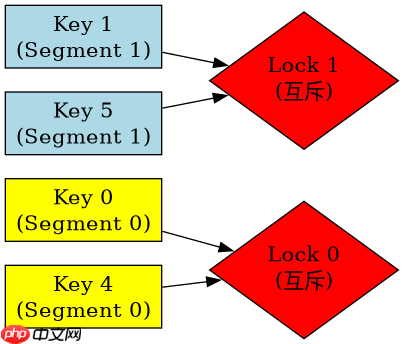
运行上述压力测试代码,可以观察到线程 t1 和 t2 几乎同时完成。这是因为 map.put(0, ...) 锁定段 0,而 map.put(1, ...) 锁定段 1。由于 SEGMENT_COUNT 为 4,且 0%4=0,1%4=1,两者无交集。若将 t2 改为 map.put(4, ...),则 4%4=0,此时 t1 和 t2 将竞争同一把锁,执行时间将接近两倍单线程时间。这证明了锁分段的有效性依赖于数据的分布均匀性。
基于输入索引 5 的锁竞争分析
针对程序中具体的输入条件,当调用 put(5, "value") 时,系统会计算出其所属的段。在 SEGMENT_COUNT = 4 的配置下,5 % 4 = 1,因此该操作将锁定索引为 1 的锁对象。这意味着任何对索引 1、5、9、13... 等模 4 余 1 的键的操作,都将串行执行。而其他模 4 余数不同的键(如 0、2、3)则可以并行操作。这种细粒度的控制确保了局部数据的线程安全,同时最大化了全局并发能力。



















