








使用 apache commons io 的 bominputstream 检测编码,核心做法是构造流时传入目标字节数组或输入流,并调用 getencoding() 方法获取识别出的字符集名称。该工具类会自动跳过文件开头的 bom(byte order mark)标记,并根据 bom 的类型(如 utf-8、utf-16be、utf-16le 等)返回对应的标准编码字符串。如果文件没有 bom,默认行为取决于配置,通常返回 null 或保持原样,需配合其他逻辑处理。
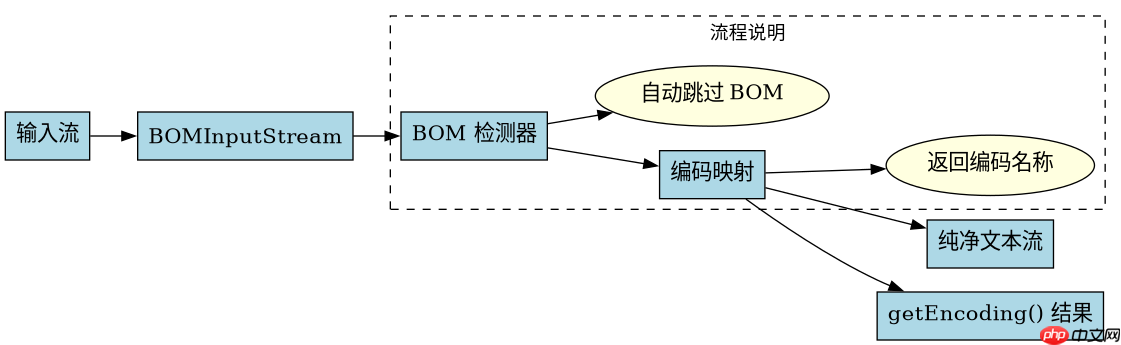
BOMInputStream 如何识别不同 BOM 标记?
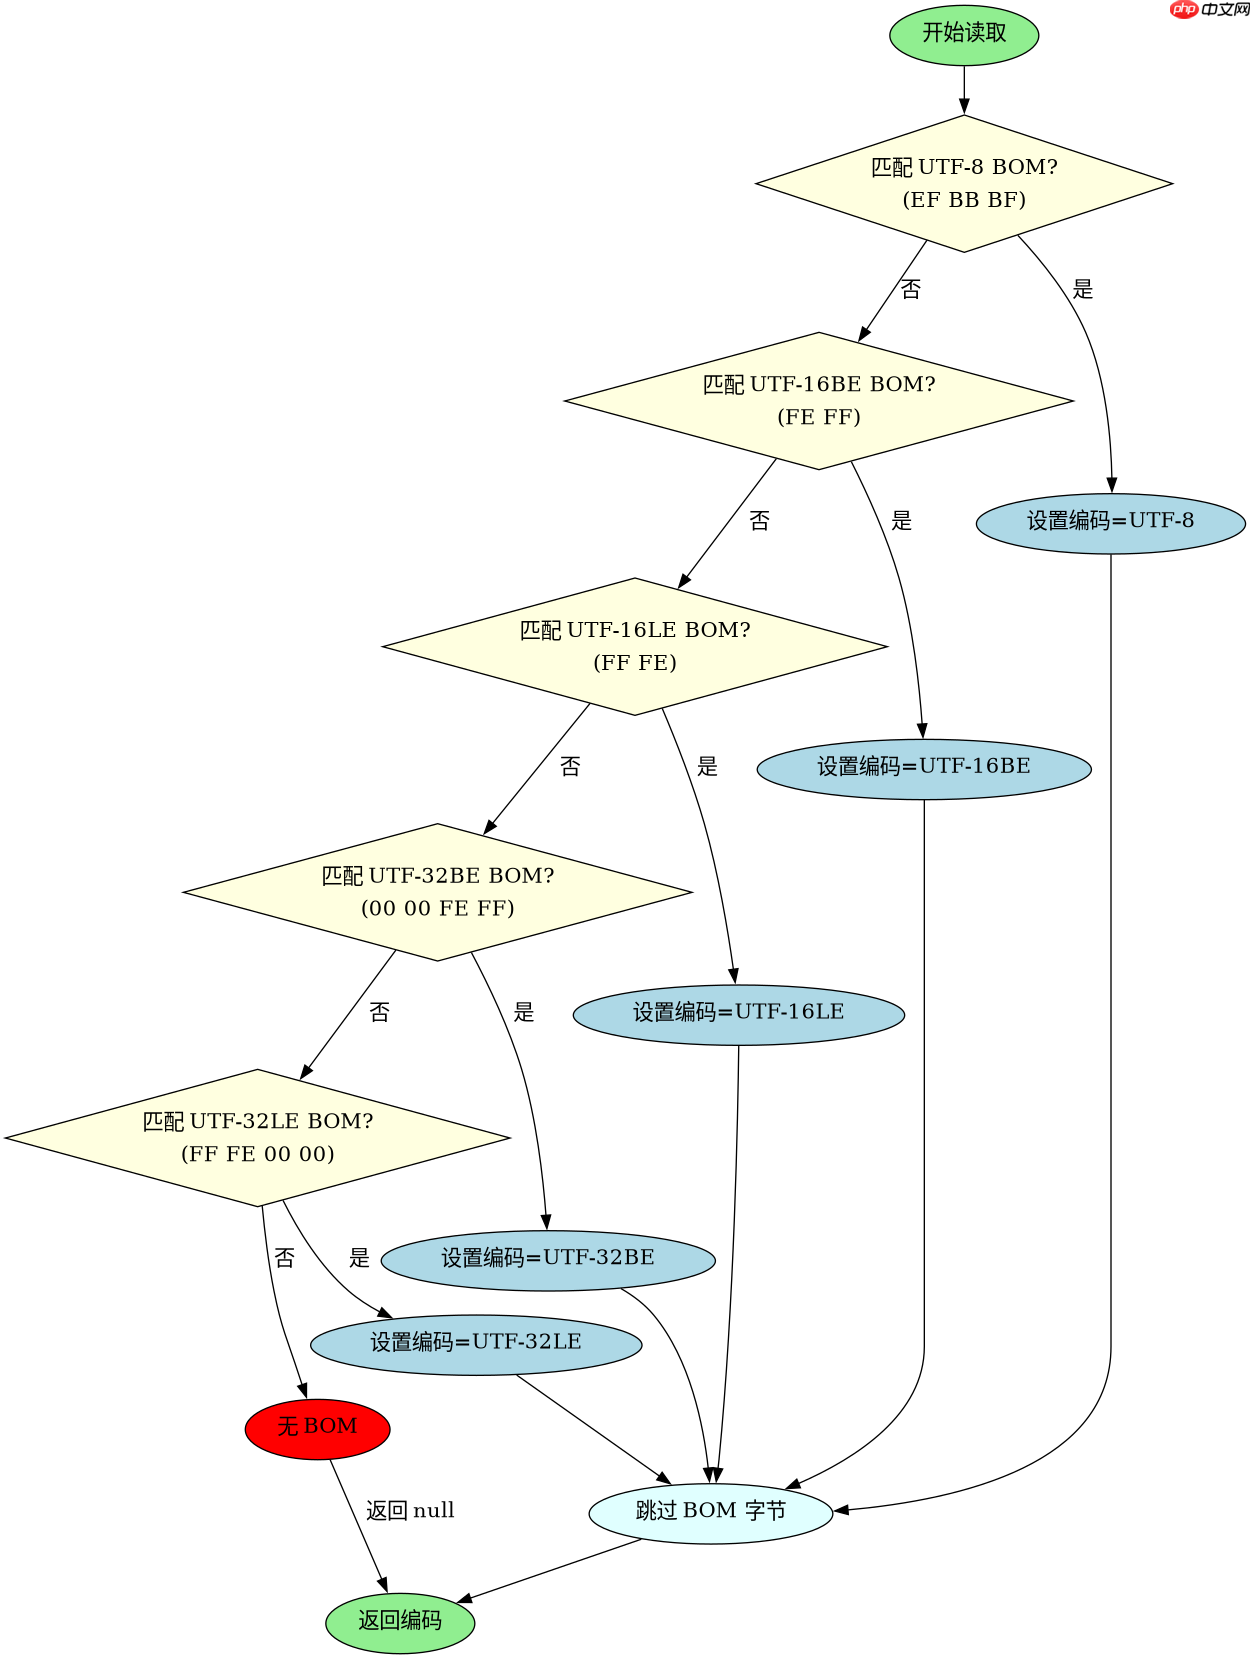
BOMInputStream 通过内置的 BOM 枚举和匹配逻辑来识别不同的字节序列。它支持常见的 Unicode BOM,包括 UTF-8 (EF BB BF)、UTF-16BE (FE FF)、UTF-16LE (FF FE)、UTF-32BE (00 00 FE FF) 和 UTF-32LE (FF FE 00 00)。当输入流读取到这些特定的前缀字节时,它会记录匹配的编码,并在后续读取中自动跳过这些字节,确保下游消费者读到的是纯净的文本内容。
import org.apache.commons.io.input.BOMInputStream;
import java.io.FileInputStream;
import java.io.IOException;

public class BOMExample {
    public static void main(String[] args) throws IOException {
        // 假设有一个带 UTF-8 BOM 的文件
        try (BOMInputStream bomStream = new BOMInputStream(
                new FileInputStream("test.txt"),
                BOM.UTF_8, BOM.UTF_16BE, BOM.UTF_16LE)) {

            String encoding = bomStream.getEncoding();
            System.out.println("Detected Encoding: " + encoding);

            // 此时读取到的数据已去除 BOM
            int data = bomStream.read();
            if (data != -1) {
                System.out.println("First byte after BOM: " + Integer.toHexString(data));
            }
        }
    }
}
上述代码演示了如何显式指定需要检测的 BOM 类型。运行后,如果文件以 UTF-8 BOM 开头,控制台将输出 Detected Encoding: UTF-8,且后续读取的数据不包含 EF BB BF 这三个字节。若文件无 BOM,getEncoding() 将返回 null。
立即学习“Java免费学习笔记(深入)”;

如何处理非 BOM 文件的编码回退?
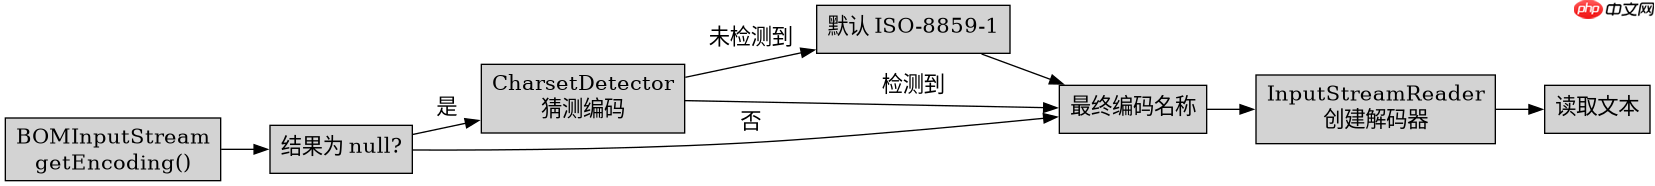
当 BOMInputStream 无法检测到 BOM 时,getEncoding() 返回 null。在实际开发中,通常需要结合 CharsetDetector 或其他启发式算法进行回退检测。Apache Commons IO 本身不提供基于内容的编码猜测功能,因此开发者需自行集成如 ICU4J 的 CharsetDetector 来处理无 BOM 的情况。这种组合策略能覆盖绝大多数文本文件的编码识别需求。
import org.apache.commons.io.input.BOMInputStream;
import com.ibm.icu.text.CharsetDetector;
import com.ibm.icu.text.CharsetMatch;
import java.io.FileInputStream;
import java.io.IOException;

public class FallbackEncodingExample {
    public static void main(String[] args) throws IOException {
        try (BOMInputStream bomStream = new BOMInputStream(
                new FileInputStream("test_no_bom.txt"))) {

            String detectedEncoding = bomStream.getEncoding();
            if (detectedEncoding == null) {
                // 回退到 CharsetDetector
                CharsetDetector detector = new CharsetDetector();
                detector.setText(bomStream.getBytes()); // 注意:实际使用中可能需要重新读取或缓存
                CharsetMatch match = detector.detect();
                if (match != null) {
                    detectedEncoding = match.getName();
                } else {
                    detectedEncoding = "ISO-8859-1"; // 默认回退
                }
            }
            System.out.println("Final Encoding: " + detectedEncoding);
        }
    }
}
此示例展示了在 BOM 缺失时的回退机制。首先尝试 BOMInputStream,若返回 null,则使用 ICU4J 的 CharsetDetector 对字节内容进行猜测。最终得到的编码名称可用于创建正确的 InputStreamReader 进行解码。注意,getBytes() 的使用需谨慎,因为 BOMInputStream 可能已经消费了部分字节,实际应用中可能需要重新打开文件或缓存原始字节。
如何验证 BOMInputStream 是否成功跳过了 BOM?
要验证 BOMInputStream 是否正确跳过了 BOM,最直接的方法是检查 getEncoding() 的返回值以及读取的第一个数据字节。如果 getEncoding() 返回了预期的编码(如 UTF-8),且第一个读取的字节不是 BOM 的一部分(例如 UTF-8 BOM 为 EF BB BF,第一个字节应为文本内容的第一个字节),则说明 BOM 已被成功跳过。此外,可以通过比较原始文件的前几个字节与流读取的前几个字节来确认。
import org.apache.commons.io.input.BOMInputStream;
import java.io.FileInputStream;
import java.io.IOException;

public class VerificationExample {
    public static void main(String[] args) throws IOException {
        byte[] originalBytes = new byte[10];
        try (FileInputStream fis = new FileInputStream("test_utf8_bom.txt")) {
            fis.read(originalBytes); // 读取前10个字节
        }

        try (BOMInputStream bomStream = new BOMInputStream(
                new FileInputStream("test_utf8_bom.txt"),
                BOM.UTF_8)) {

            String encoding = bomStream.getEncoding();
            System.out.println("Encoding: " + encoding);

            // 读取前10个字节
            byte[] streamBytes = new byte[10];
            bomStream.read(streamBytes);

            // 比较:原始前3字节应为 BOM,流读取的前3字节应为文本内容
            System.out.println("Original first 3 bytes: " + toHex(originalBytes, 3));
            System.out.println("Stream first 3 bytes: " + toHex(streamBytes, 3));
        }
    }

    private static String toHex(byte[] bytes, int len) {
        StringBuilder sb = new StringBuilder();
        for (int i = 0; i < len && i < bytes.length; i++) {
            sb.append(String.format("%02X ", bytes[i]));
        }
        return sb.toString();
    }
}
运行此验证代码,如果文件以 UTF-8 BOM 开头,Original first 3 bytes 将显示 EF BB ,而 Stream first 3 bytes 将显示文本内容的第一个字节的十六进制值(例如,如果文本是 "A",则为 41 )。这证明了 BOMInputStream 正确跳过了 BOM 标记。



















