








java 中可以通过调用 arraylist 的 spliterator() 方法获取一个支持并行的拆分迭代器,进而利用 foreachremaining 或流式 api 实现并行遍历。具体做法是创建该迭代器后,使用 trysplit 将数据切分为多个子任务分发给不同线程处理,或者直接将迭代器包装为 streamsupport.stream 并开启并行模式。这样做能充分利用多核 cpu 提升处理大量元素时的吞吐量,但需注意迭代器本身不是线程安全的,必须确保在遍历期间源列表不被修改。
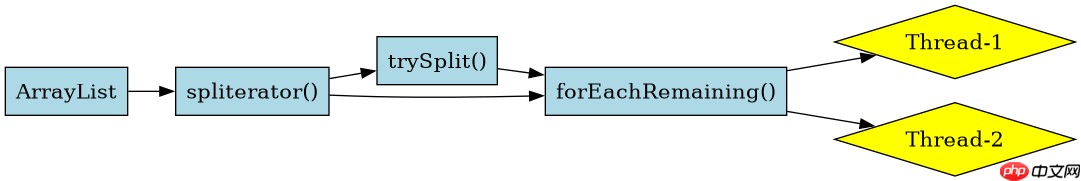
如何手动拆分 spliterator 进行多线程处理
手动拆分的核心在于利用 trySplit 方法将当前迭代器划分为两个部分,其中一个继续由当前线程处理,另一个返回给新线程。通过递归或循环不断调用 trySplit,直到无法再拆分或达到预设的线程数,即可实现细粒度的并行控制。这种方式适合需要自定义任务调度逻辑的场景。
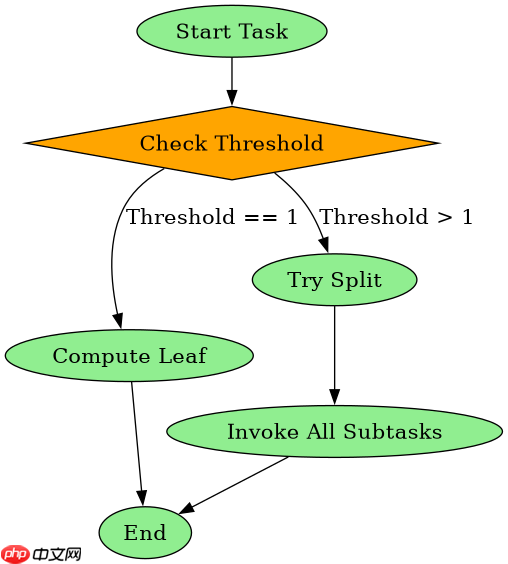
import java.util.ArrayList;
import java.util.Spliterator;
import java.util.concurrent.ForkJoinPool;
import java.util.concurrent.RecursiveAction;

public class ManualParallelSpliterator {
    public static void main(String[] args) {
        ArrayList<String> list = new ArrayList<>();
        for (int i = 0; i < 100; i++) {
            list.add("Item-" + i);
        }

        Spliterator<String> split = list.spliterator();
        Task task = new Task(split, 4);
        ForkJoinPool.commonPool().invoke(task);
    }

    static class Task extends RecursiveAction {
        private final Spliterator<String> split;
        private final int threshold;

        public Task(Spliterator<String> split, int threshold) {
            this.split = split;
            this.threshold = threshold;
        }

        @Override
        protected void compute() {
            if (threshold == 1) {
                split.forEachRemaining(item -> System.out.println(Thread.currentThread().getName() + ": " + item));
            } else {
                Spliterator<String> subSplit = split.trySplit();
                if (subSplit != null) {
                    invokeAll(new Task(subSplit, threshold / 2), new Task(split, threshold / 2));
                } else {
                    split.forEachRemaining(item -> System.out.println(Thread.currentThread().getName() + ": " + item));
                }
            }
        }
    }
}
运行上述代码,控制台将输出类似以下的结果(线程名可能不同): ForkJoinPool.commonPool-worker-1: Item-0 ForkJoinPool.commonPool-worker-2: Item-50 ... 其他线程处理剩余项
如何通过 StreamSupport 简化并行遍历
使用 StreamSupport.stream 可以将 Spliterator 转换为 Stream 对象,随后调用 .parallel() 即可启用并行流。这是最简洁的并行遍历方式,底层会自动处理拆分和合并逻辑,适用于大多数不需要复杂调度的场景。需要注意的是,并行流在处理小数据集时可能因开销过大而变慢,建议仅在数据量较大时使用。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
立即学习“Java免费学习笔记(深入)”;

import java.util.ArrayList;
import java.util.Spliterator;
import java.util.stream.StreamSupport;

public class StreamParallelSpliterator {
    public static void main(String[] args) {
        ArrayList<Integer> list = new ArrayList<>();
        for (int i = 0; i < 1000; i++) {
            list.add(i);
        }

        Spliterator<Integer> split = list.spliterator();
        StreamSupport.stream(split, true)
            .forEach(item -> System.out.println(Thread.currentThread().getName() + ": " + item));
    }
}
预期结果:所有元素被随机分配到不同的线程进行处理,输出顺序不确定,但每个元素仅被处理一次。例如:
ForkJoinPool.commonPool-worker-1: 123
ForkJoinPool.commonPool-worker-2: 456
...
当 spliterator 遇到空列表时会发生什么
当 ArrayList 为空时,其 spliterator() 返回的迭代器在调用 tryAdvance 时会立即返回 false,且 trySplit 也会返回 null。这意味着无论是手动拆分还是使用并行流,都不会执行任何实际的处理逻辑,也不会抛出异常。这种行为符合迭代器的通用契约,即空集合无需进一步操作。



















