








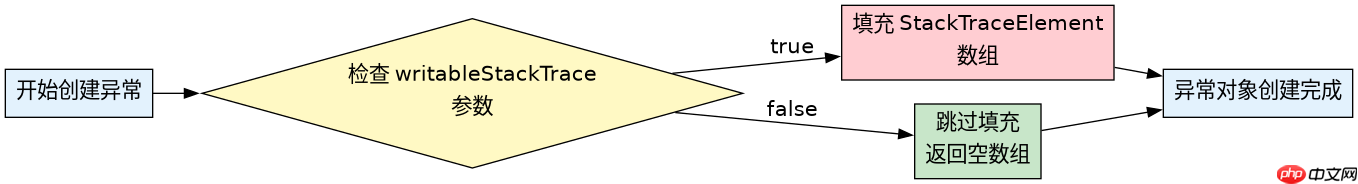
在 java 中,调用 fillinstacktrace() 优化性能的核心做法是:在自定义异常类的构造函数中,通过 super(message, cause, enablesuppression, writablestacktrace) 传递参数,将 writablestacktrace 设置为 false。这样 jvm 会跳过栈轨迹的生成和填充过程,直接返回一个空的栈轨迹数组。这种做法能显著减少对象创建时的 cpu 开销和内存分配,特别适用于那些仅用于业务逻辑流转(如控制流程)而非调试定位的异常场景。
为什么默认异常处理性能较差?
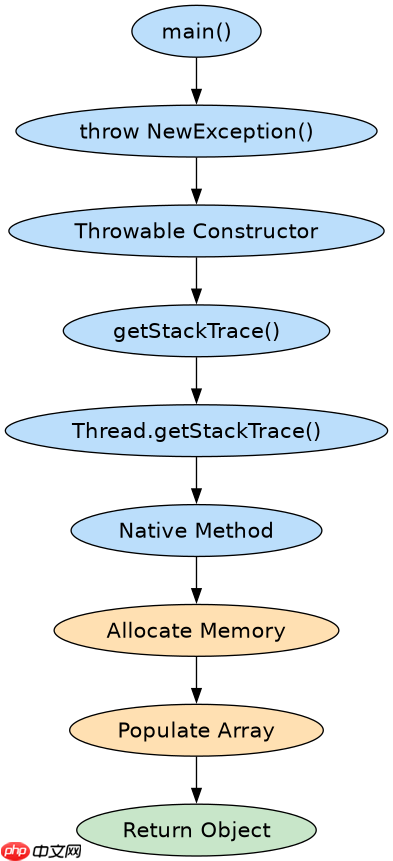
默认情况下,当你在 Java 中抛出或创建一个 Throwable 实例时,JVM 会自动执行栈追踪的捕获、解析和存储操作。这个过程涉及遍历当前线程的调用栈,获取每一帧的方法名、类名、文件名和行号信息,并将其序列化到 StackTraceElement 数组中。对于高频触发的异常,这种重复的 I/O 和内存分配操作会成为明显的性能瓶颈。
import java.util.List;
import java.util.ArrayList;

public class PerformanceTest {
    // 定义一个禁用栈追踪的自定义异常
    static class OptimizedException extends RuntimeException {
        public OptimizedException(String message) {
            super(message, null, false, false);
        }
    }

    // 定义一个普通异常作为对比
    static class NormalException extends RuntimeException {
        public NormalException(String message) {
            super(message);
        }
    }

    public static void main(String[] args) {
        int iterations = 1000000;

        long startNormal = System.nanoTime();
        for (int i = 0; i < iterations; i++) {
            try {
                throw new NormalException("Normal Exception");
            } catch (NormalException e) {
                // 忽略
            }
        }
        long endNormal = System.nanoTime();
        System.out.println("Normal Exception Time: " + (endNormal - startNormal) / 1_000_000 + " ms");

        long startOptimized = System.nanoTime();
        for (int i = 0; i < iterations; i++) {
            try {
                throw new OptimizedException("Optimized Exception");
            } catch (OptimizedException e) {
                // 忽略
            }
        }
        long endOptimized = System.nanoTime();
        System.out.println("Optimized Exception Time: " + (endOptimized - startOptimized) / 1_000_000 + " ms");
    }
}
运行上述代码,你会发现 OptimizedException 的执行时间远小于 NormalException。这是因为 super(message, null, false, false) 中的第四个参数 false 告诉 JVM 不需要填充栈轨迹。注意,第三个参数 enableSuppression 也必须设为 false,因为如果启用了抑制功能,JVM 可能仍需要某些栈信息来确定哪些异常被抑制了。因此,必须同时禁用两者才能最大化性能提升。
立即学习“Java免费学习笔记(深入)”;

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
如何正确实现可复用的无栈异常类?
为了实现可复用的无栈异常,你需要继承 RuntimeException 或 Error,并在所有构造函数中显式调用父类带有四个参数的构造函数。关键在于确保 writableStackTrace 始终为 false。此外,由于栈轨迹为空,printStackTrace() 方法将不会输出任何有用的调试信息,因此在生产环境中使用此类异常时,应确保日志记录机制能够捕获异常消息和原因,而不是依赖栈轨迹。

public class BusinessFlowException extends RuntimeException {

    public BusinessFlowException(String message) {
        super(message, null, false, false);
    }

    public BusinessFlowException(String message, Throwable cause) {
        super(message, cause, false, false);
    }

    public BusinessFlowException(Throwable cause) {
        super(cause.getMessage(), cause, false, false);
    }

    // 可选:重写 fillInStackTrace 以进一步确保行为一致
    @Override
    public synchronized Throwable fillInStackTrace() {
        return this;
    }
}
在上述代码中,我们提供了多种构造函数以适应不同的使用场景。无论哪种构造方式,都通过 super(..., false, false) 禁用了栈轨迹。此外,重写了 fillInStackTrace() 方法,使其直接返回 this,这可以防止在某些边缘情况下 JVM 尝试重新填充栈轨迹。需要注意的是,如果异常被用于 try-with-resources 或自动关闭资源,且需要保留原始异常的链式关系,请确保在构造函数中正确传递 cause 参数,即使栈轨迹被禁用,原因链仍然有效。
基于程序中某个输入、条件或结果的具体问题
当使用无栈异常时,如果程序试图通过 e.getStackTrace() 获取栈信息,将返回一个空数组。这是一个常见的陷阱,特别是在调试工具或日志框架中,它们可能期望栈轨迹存在。因此,在使用此类异常前,必须确认下游组件不会依赖栈轨迹进行逻辑判断或展示。例如,如果有一个监控服务定期扫描异常日志并统计错误来源,无栈异常会导致该服务无法识别错误发生的代码位置,从而失去监控价值。在这种情况下,应权衡性能与可观测性,仅在确实不需要调试信息的场景下使用无栈异常。



















