








Java HashSet 怎么用去重统计处理数据
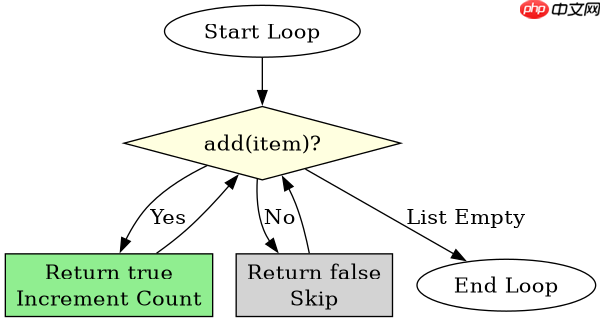
使用 hashset 进行去重统计的核心做法是:将待处理的数据逐个添加到集合中,利用其自动忽略重复元素的特性完成去重,最后通过 size() 方法获取唯一数据的数量。在添加过程中,如果数据量较大或需要保留原始顺序,建议结合业务逻辑判断;若仅需最终结果,直接调用 add() 并检查返回值即可确认是否为新元素。

如何高效实现基于 HashSet 的去重与计数
要实现高效的去重与计数,最直接的方式是利用 HashSet 的 add() 方法。该方法在元素不存在时返回 true 并插入元素,存在时返回 false。开发者可以通过遍历输入列表,累加 add() 的返回值来统计新增的唯一项数量,或者在遍历结束后直接读取集合的大小。这种方法避免了手动编写复杂的比较逻辑,时间复杂度接近 O(N)。

使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查
下载
使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
import java.util.HashSet;
import java.util.List;

public class DeduplicationExample {
    public static void main(String[] args) {
        List<String> data = List.of("apple", "banana", "apple", "orange", "banana");
        HashSet<String> uniqueItems = new HashSet<>();
        int addedCount = 0;

        for (String item : data) {
            if (uniqueItems.add(item)) {
                addedCount++;
            }
        }

        System.out.println("Unique items count: " + uniqueItems.size());
        System.out.println("Added count during iteration: " + addedCount);
    }
}
HashSet 在处理空值时的行为表现
当输入数据中包含 null 值时,HashSet 的行为表现为只允许存储一个 null 实例。如果在去重统计的过程中遇到 null,第一次添加会成功并计入总数,后续再次添加 null 则会失败且不增加集合大小。这一特性意味着在统计包含空值的列表时,null 会被视为一种唯一的“缺失”状态,而不是导致错误或忽略的特殊情况。
立即学习“Java免费学习笔记(深入)”;
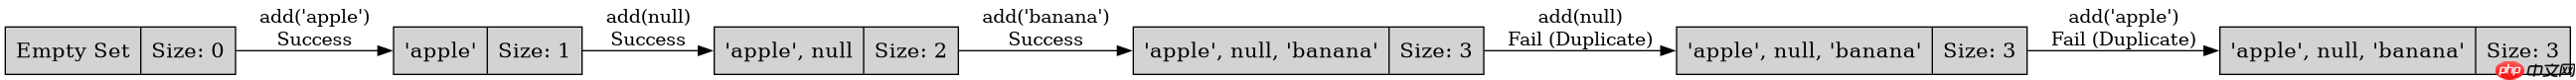
import java.util.HashSet;
import java.util.List;

public class NullHandlingExample {
    public static void main(String[] args) {
        List<String> dataWithNull = List.of("apple", null, "banana", null, "apple");
        HashSet<String> set = new HashSet<>();

        for (String item : dataWithNull) {
            set.add(item);
        }

        // 输出应为 3: "apple", "banana", null
        System.out.println("Size with nulls: " + set.size());
    }
} 

















