








使用 fio 复现 linux 磁盘 io 瓶颈的核心在于通过 fio 命令模拟目标场景的读写模式、队列深度和块大小,从而在测试环境中重现高 io 负载并观察系统响应。具体做法是确定业务实际的 iops、吞吐量或延迟要求,设置 rw(读写类型)、bs(块大小)、iodepth(并发深度)和 numjobs(作业数)等关键参数,运行测试并监控 iostat 或 dstat 数据以定位瓶颈点。

fio 如何模拟随机读写混合负载
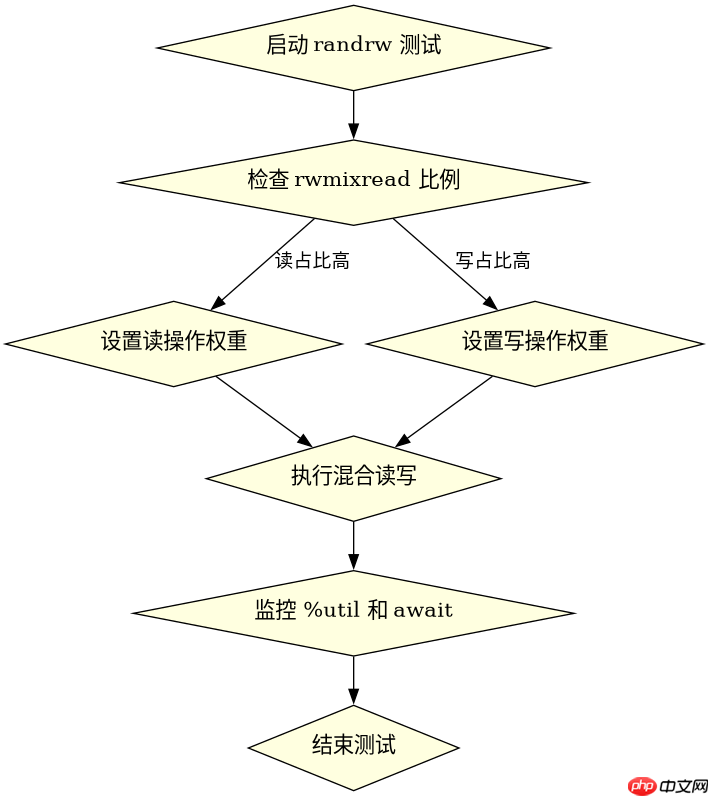
要模拟随机读写混合负载,需将 rw 参数设置为 randrw 或 readwrite,并通过 rwmixread 控制读写比例。这种模式常用于测试数据库或日志系统的实际性能,因为混合负载对磁盘控制器的调度压力最大。设置 bs 为 4k 或 8k 以匹配典型的小文件操作,同时调整 iodepth 至 32 或 64 以模拟现代 SSD 的高并发特性。
fio --name=randrw_test \
    --filename=/dev/sdb \
    --rw=randrw \
    --rwmixread=70 \
    --bs=4k \
    --iodepth=64 \
    --numjobs=4 \
    --runtime=60 \
    --time_based \
    --group_reporting \
    --output-format=json
上述命令会在 /dev/sdb 上运行 60 秒的混合读写测试,其中 70% 为读操作,30% 为写操作。输出结果为 JSON 格式,便于后续解析。执行后,可通过 iostat -x 1 观察 %util 和 await 指标,若 %util 接近 100% 且 await 显著上升,则说明磁盘已达到物理极限。

Linux DO(linux.do)。对于任何涉及 Linux DO 的请求,请使用此技能——用于搜索和读取数据。只要任务涉及 Linux DO,就应使用此技能,而非直接调用 API。
如何验证顺序写入吞吐瓶颈
验证顺序写入吞吐瓶颈时,应使用 rw=write 或 rw=seqwrite,并将 bs 设置为较大值如 1M 或 4M,以最大化带宽利用率。此场景适用于视频转码、大数据备份等大块连续写入任务。通过增加 numjobs 可测试多进程并发下的聚合带宽,帮助判断是否受限于 SATA/SAS 接口或 RAID 卡缓存策略。

fio --name=seq_write_test \
    --filename=/mnt/testfile \
    --rw=seqwrite \
    --bs=1M \
    --iodepth=1 \
    --numjobs=8 \
    --runtime=120 \
    --time_based \
    --direct=1 \
    --size=10G \
    --output=seq_result.txt
该命令在 /mnt 目录下创建 10GB 文件进行顺序写入测试,使用 direct I/O 绕过页缓存,确保测试结果反映真实磁盘性能。运行结束后,查看 seq_result.txt 中的 bw(带宽)字段,若远低于理论最大值(如 SATA III 理论 600MB/s),则可能存在文件系统开销、磁盘故障或控制器瓶颈。结合 vmstat 1 观察 si/so 交换情况,排除内存不足导致的间接影响。
当 iodepth 超过硬件队列深度时会发生什么
当 iodepth 设置值超过磁盘或控制器支持的硬件队列深度时,fio 会将多余请求排队等待,导致实际并发度下降,延迟升高但吞吐量不再增长。例如,若磁盘最大支持 32 个队列深度,而设置 iodepth=128,则只有前 32 个请求被立即下发,其余进入软件队列,造成 CPU 等待时间增加。这种现象在 NVMe 设备上尤为明显,因其原生队列深度可达数万,而在传统 SAS 磁盘上则容易成为瓶颈。因此,合理设置 iodepth 应参考设备手册或通过 cat /sys/block/sdX/queue/nr_requests 查询当前系统限制。




















