








使用 du 统计 linux 目录占用大小,核心命令是 du -sh [目录路径]。其中 -s 参数用于汇总显示总计大小,-h 参数将字节数转换为人类可读的格式(如 kb、mb、gb)。执行该命令后,终端会直接输出该目录下所有文件和子目录的总占用空间。
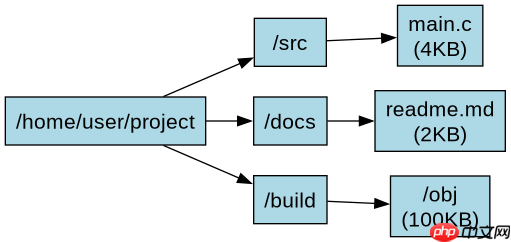
du 如何递归统计各子目录的大小
若需查看目录内每个子文件夹的具体占用情况,应去掉 -s 参数并保留 -h,即运行 du -h [目录路径]。此时 du 会递归遍历所有子目录,逐行打印每个层级的累计大小。默认情况下,输出结果按文件在磁盘中的实际存储顺序排列,而非按大小排序。为了便于快速定位大文件所在的目录,通常配合 sort -h 命令使用,这样可以将结果按数值大小升序排列,最占空间的目录会出现在列表末尾。
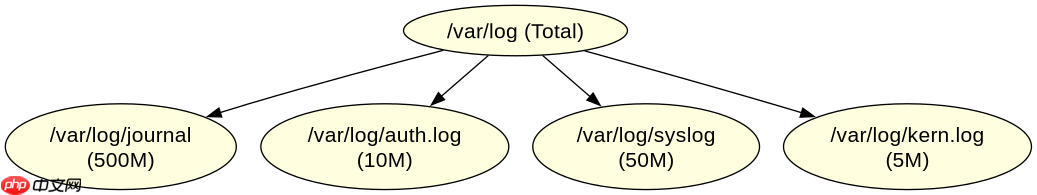
du -h /var/log | sort -h
上述命令会列出 /var/log 下所有子目录及文件的累计大小,并按从小到大的顺序显示。例如,如果 /var/log/journal 占用最大,它将显示在最后一行。这种组合方式能直观地反映出哪些子目录是“空间大户”,帮助开发者快速定位需要清理或优化的目标。注意,du 统计的是文件系统层面的块占用,可能包含硬链接重复计算的情况,但对于常规排查已足够准确。
如何排除特定文件或目录以优化统计速度
当目标目录包含大量无需统计的文件(如缓存、日志轮转文件)时,全量统计会非常耗时。此时可以使用 --exclude 参数指定忽略的模式。例如,运行 du -sh --exclude='*.log' /data 可以跳过所有以 .log 结尾的文件。对于更复杂的排除需求,如排除整个目录树,可以使用 --exclude-dir=cache。这些过滤条件会在 du 遍历文件系统时直接跳过匹配项,从而显著减少 I/O 操作和计算时间,使统计结果更聚焦于有效数据。

Linux DO(linux.do)。对于任何涉及 Linux DO 的请求,请使用此技能——用于搜索和读取数据。只要任务涉及 Linux DO,就应使用此技能,而非直接调用 API。

du -h --exclude='*.tmp' --exclude-dir='.git' /project
该命令在统计 /project 目录时,会忽略所有 .tmp 临时文件以及 .git 版本控制目录。这在实际开发中非常有用,因为 .git 目录通常体积庞大且不属于业务代码本身。通过合理设置排除规则,可以得到更贴近业务实际存储需求的统计结果,同时避免对系统元数据进行不必要的扫描。
基于 du -b 输入获取精确字节数进行程序处理
在脚本或程序中处理目录大小时,人类可读格式(-h)因包含单位后缀(如 M、G)而不利于直接计算。此时应使用 -b 参数,即 du -sb [目录路径]。该参数强制输出纯字节数,无单位后缀,方便后续通过管道传递给 awk 或其他工具进行数值比较或格式化。例如,在监控脚本中,可以直接提取该数值并与阈值进行比较,判断是否触发告警。
size=$(du -sb /app/data | awk '{print $1}')
echo "Size in bytes: $size"
此段代码首先调用 du -sb 获取 /app/data 的字节总数,然后使用 awk 提取第一列(即大小数值),赋值给变量 size。最终输出的 size 是一个整数,可直接用于数学运算。这种方法避免了手动解析 -h 输出中复杂单位转换的麻烦,确保了程序逻辑的简洁性和准确性。




















