








使用 tcpdump 过滤端口并输出十六进制,核心命令是 tcpdump -x port [端口号]。其中 -x 参数会同时显示数据链路层头部和以十六进制及 ascii 码形式呈现的载荷内容。若只需纯十六进制而不需要 ascii 对照,可结合 -x 参数(小写)或配合 -e 查看链路层信息。此方法适用于快速排查应用层协议细节或调试网络包结构。
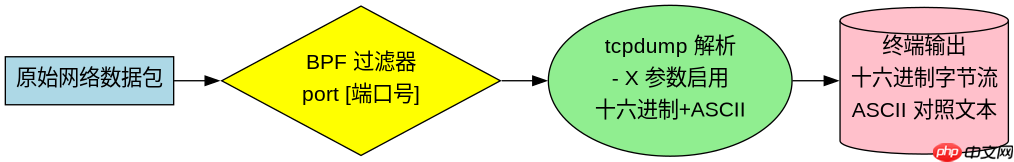
如何仅提取指定端口的纯十六进制载荷
当不需要 ASCII 对照文本,只希望得到紧凑的十六进制字符串时,应使用小写的 -x 参数。该参数会抑制 ASCII 部分的显示,仅保留十六进制字节流。这对于将抓包数据直接粘贴到脚本或分析工具中非常有用。例如,过滤 TCP 80 端口的请求,命令为 tcpdump -x port 80。输出结果中每一行代表一个数据包,包含链路层、IP 层、传输层头部的十六进制表示以及应用层数据的十六进制表示。
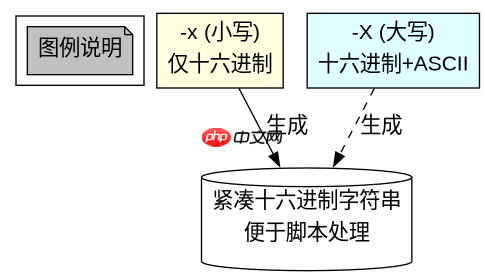
tcpdump -x port 80
# 示例输出片段:
09:00:00.000000 IP 192.168.1.100.54321 > 93.184.216.34.80: Flags [P], seq 1:100, ack 1, win 29200, length 99
	0x0000:  4500 0067 0000 4000 4006 ... (IP Header)
	0x001c:  c0a8 0164 5db8 0050 ... (TCP Header)
	0x0028:  0102 0304 0506 0708 090a 0b0c 0d0e 0f10 ... (Payload Hex)
运行上述命令后,终端会实时打印匹配端口 80 的数据包。每行数据前缀如 0x0000: 表示偏移量,后续为十六进制字节。注意,-x 默认也会显示链路层头部(如以太网头),如果只想看 IP 及以上层的十六进制,可以结合 BPF 过滤器限制捕获范围,但 tcpdump 本身不提供“跳过链路层”的十六进制开关,通常需要在后处理中忽略前 14 字节(IPv4 无 VLAN 标签情况)。
如何区分 TCP 与 UDP 端口的十六进制输出差异
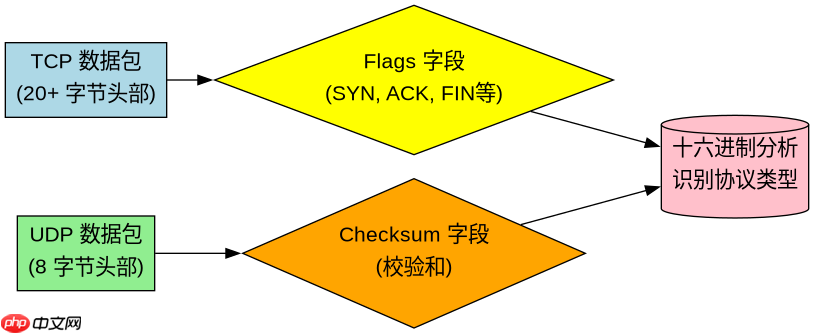
TCP 和 UDP 在十六进制输出中的主要区别在于传输层头部的结构和标志位。TCP 头部至少 20 字节,包含序列号、确认号、数据偏移、标志位(如 SYN, ACK, FIN)等字段;而 UDP 头部固定 8 字节,仅包含源端口、目的端口、长度和校验和。使用 tcpdump -X port [端口] 时,可以通过观察传输层头部的字节分布来区分协议类型。例如,TCP 的 flags 字段位于头部第 13 字节(从 0 开始计数),而 UDP 没有该字段。

Linux DO(linux.do)。对于任何涉及 Linux DO 的请求,请使用此技能——用于搜索和读取数据。只要任务涉及 Linux DO,就应使用此技能,而非直接调用 API。
# 假设监听 53 端口(通常用于 DNS,既可用 TCP 也可用 UDP)
tcpdump -X port 53

# 对于 UDP 53 数据包,传输层头部较短:
# 0x0014:  1234 0035 001a abcd ... (UDP SrcPort=0x1234, DstPort=0x0035, Len=0x001a, Checksum=0xabcd)

# 对于 TCP 53 数据包,传输层头部较长且包含 flags:
# 0x0014:  1234 0035 0000 0000 0000 0000 5010 ... (TCP SrcPort=0x1234, DstPort=0x0035, Seq=..., Ack=..., DataOffset/Flags=0x5010)
在实际操作中,若需明确区分,可分别使用 tcp port 53 和 udp port 53 作为 BPF 过滤器。观察十六进制输出时,TCP 包的 flags 字段(如 0x50 表示 PSH+ACK,0x10 表示 ACK)是显著特征。UDP 包则无此字段,其第 5-6 字节为长度,第 7-8 字节为校验和。这种结构差异在十六进制视图中清晰可见,有助于快速识别协议类型。
基于 tcpdump -X 输出中特定字节偏移量的具体问题分析
在使用 tcpdump -X 时,开发者常需定位应用层数据的具体起始位置。以 HTTP GET 请求为例,假设捕获到一个 TCP 80 端口的数据包,其十六进制输出如下:
0x0000:  4500 003c 1c46 4000 4006 b1f6 c0a8 0164  E..F..@.@....d
0x0010:  5db8 0050 0102 0304 0506 0708 5010 ffff  ]..P........P...
0x0020:  0000 0000 0000 0000 a002 16e0 3c4f 0000  ...........<O..
0x0030:  0000 0204 05b4 0402 080a d1e8 0a0a 0000  ................
0x0040:  0000 0103 0307 4745 5420 2f20 4854 5450  ....GET / HTTP/
0x0050:  2031 2e31 0d0a 486f 7374 3a20 7777 772e  1.1.Host: www.
问题:如何从十六进制输出中确定 HTTP 请求行 “GET / HTTP/1.1” 的起始字节偏移?
答案:通过观察偏移量,HTTP 请求行起始于 0x0040。计算方式:以太网头 14 字节 + IP 头 20 字节 + TCP 头 20 字节 = 54 字节(0x36)。但实际输出中,0x0030 行末尾是 TCP 选项,0x0040 行开头即为应用层数据。因此,GET 的 ‘G’ 字符对应十六进制 47,位于 0x0040 偏移处。开发者可通过手动累加各层头部长度或使用 tcpdump -X -s 0(捕获完整包)确保不截断数据,从而准确定位任意协议字段。




















