








postgresql中利用string_agg实现去重后的文本聚合,核心做法是先使用distinct关键字配合group by对数据进行分组和去重,再调用string_agg函数将去重后的文本按指定分隔符拼接。具体而言,在select语句中对需要聚合的列使用distinct修饰,并设置order by确保结果稳定,最终得到每个组内不重复且有序的连接字符串。

如何对单列进行去重拼接
当只需要对单个字段进行去重拼接时,直接在STRING_AGG函数内部使用DISTINCT关键字即可。例如,假设有一张表记录了用户的多条标签,我们希望获取每个用户的所有不重复标签并用逗号连接。此时只需在SELECT中指定用户ID,并对标签列使用STRING_AGG(DISTINCT tag, ','),同时通过GROUP BY user_id进行分组。这样数据库会在聚合前先去重,再执行拼接操作,返回的结果即为每个用户的去重标签列表。
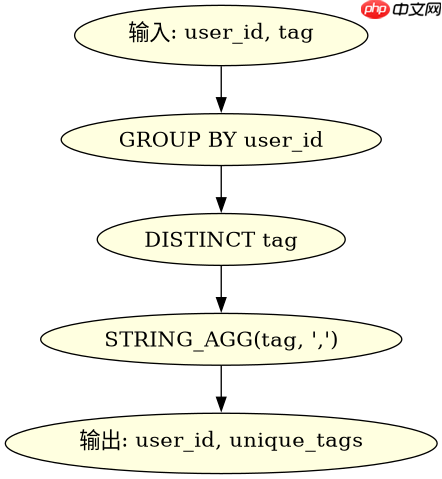
CREATE TABLE user_tags (user_id INT, tag VARCHAR(50));
INSERT INTO user_tags VALUES
(1, 'SQL'),
(1, 'Python'),
(1, 'SQL'),
(2, 'Java'),
(2, 'C++'),
(2, 'Java');

SELECT user_id,
       STRING_AGG(DISTINCT tag, ', ') AS unique_tags
FROM user_tags
GROUP BY user_id;
-- 预期输出:
-- user_id | unique_tags
-- 1       | SQL, Python
-- 2       | Java, C++
如何处理多列关联的去重拼接
若需基于多个条件进行去重拼接,例如先按部门分组,再对部门内的员工姓名去重后拼接,可以在GROUP BY中包含多个列,并在STRING_AGG中使用DISTINCT。此外,如果涉及跨表查询,应先通过JOIN关联数据,再应用相同的去重聚合逻辑。关键在于确保GROUP BY的列组合能唯一标识一个组,而DISTINCT作用于聚合列,从而保证同一组内没有重复值。这种场景下,建议显式指定ORDER BY以控制拼接顺序,避免结果因执行计划不同而产生差异。

CREATE TABLE departments (dept_id INT, dept_name VARCHAR(50));
CREATE TABLE employees (emp_id INT, emp_name VARCHAR(50), dept_id INT);

INSERT INTO departments VALUES (1, 'Engineering'), (2, 'Sales');
INSERT INTO employees VALUES
(1, 'Alice', 1),
(2, 'Bob', 1),
(3, 'Alice', 1),
(4, 'Charlie', 2),
(5, 'David', 2),
(6, 'Charlie', 2);

SELECT d.dept_name,
       STRING_AGG(DISTINCT e.emp_name, ', ' ORDER BY e.emp_name) AS staff_list
FROM departments d
JOIN employees e ON d.dept_id = e.dept_id
GROUP BY d.dept_name;
-- 预期输出:
-- dept_name   | staff_list
-- Engineering | Alice, Bob
-- Sales       | Charlie, David
STRING_AGG去重时ORDER BY的作用是什么
在STRING_AGG去重拼接中,ORDER BY用于控制最终拼接字符串中元素的顺序。虽然DISTINCT确保了值的唯一性,但若不指定ORDER BY,结果的顺序可能不确定,尤其在并行执行或数据分布变化时。因此,添加ORDER BY子句(如ORDER BY column_name)可使结果可预测,便于调试和比较。例如在上述示例中,使用ORDER BY e.emp_name确保员工姓名按字母顺序排列,从而每次查询都返回相同格式的字符串。这是生产环境中推荐的最佳实践,避免因隐式排序导致的不一致问题。


















