








在sql中使用 cume_dist() 计算成绩累积分布概率,核心是调用窗口函数 cume_dist() over (order by score)。该函数返回当前行在分组或全表中的相对位置,即小于等于当前值的行数占总行数的比例。例如,若某学生分数为85分,且共有100名学生,有90人的分数小于等于85,则其累积分布为0.9。此方法适用于评估个体在整体中的排名百分位,常用于成绩分析、绩效评估等场景。

CUME_DIST与PERCENT_RANK的区别是什么
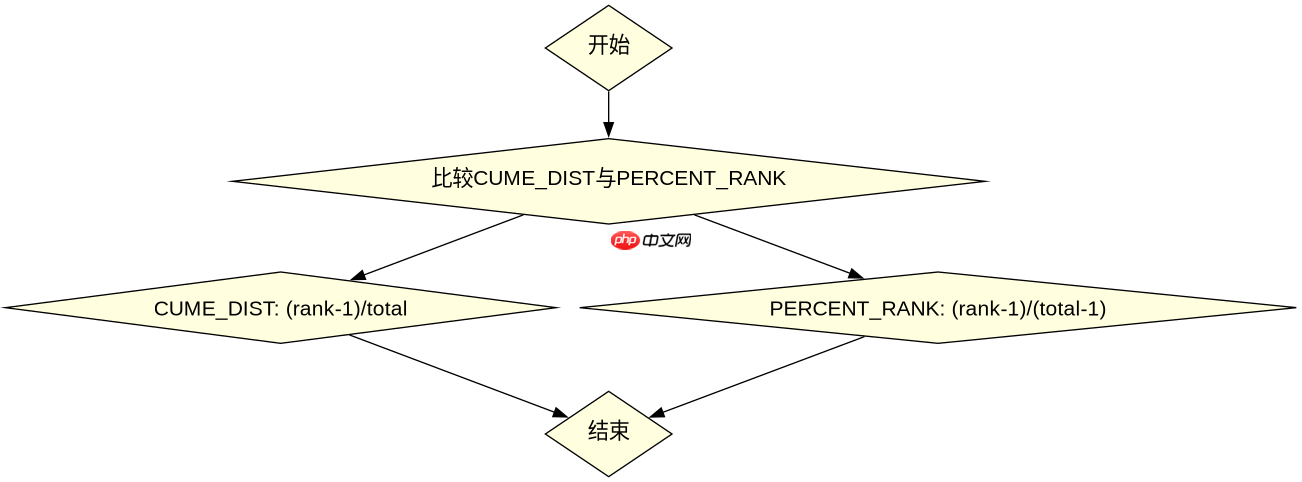
CUME_DIST() 和 PERCENT_RANK() 都用于计算相对位置,但计算公式不同。CUME_DIST() 基于累计频数,公式为 (rank - 1) / total_rows;而 PERCENT_RANK() 基于排序差值,公式为 (rank - 1) / (total_rows - 1)。当数据存在重复值时,两者结果可能差异显著。例如,若有10个相同最高分,CUME_DIST() 会给出0.9(9/10),而 PERCENT_RANK() 会给出1.0(9/9)。选择依据是业务需求:关注“有多少比例的人低于你”用 CUME_DIST(),关注“你在排序中的相对跨度”用 PERCENT_RANK()。
WITH scores AS (
  SELECT 'Alice' AS name, 85 AS score UNION ALL
  SELECT 'Bob', 90 UNION ALL
  SELECT 'Charlie', 85 UNION ALL
  SELECT 'Diana', 78
)
SELECT
  name,
  score,
  CUME_DIST() OVER (ORDER BY score) AS cum_dist,
  PERCENT_RANK() OVER (ORDER BY score) AS pct_rank
FROM scores;
预期输出:
Alice: 0.5, 0.33
Bob: 1.0, 1.0
Charlie: 0.5, 0.33
Diana: 0.25, 0.0
如何处理并列成绩对CUME_DIST的影响
当存在并列成绩时,CUME_DIST() 会将所有并列行视为同一等级,并赋予相同的累积分布值。例如,两个85分的学生都会得到相同的 CUME_DIST() 值,因为函数统计的是“小于等于当前值”的行数。这可能导致多个用户获得相同的百分位,但这是符合统计逻辑的。若需打破并列,可结合 DENSE_RANK() 或 ROW_NUMBER() 进行二次排序,但 CUME_DIST() 本身不处理并列打破,仅反映原始数据的分布状态。

WITH scores AS (
  SELECT 'Alice' AS name, 85 AS score UNION ALL
  SELECT 'Bob', 90 UNION ALL
  SELECT 'Charlie', 85 UNION ALL
  SELECT 'Diana', 78
)
SELECT
  name,
  score,
  CUME_DIST() OVER (ORDER BY score) AS cum_dist,
  DENSE_RANK() OVER (ORDER BY score) AS dense_rank
FROM scores;
预期输出:
Alice: 0.5, 2
Bob: 1.0, 4
Charlie: 0.5, 2
Diana: 0.25, 1
CUME_DIST在特定输入条件下的具体表现
当输入数据包含空值(NULL)时,CUME_DIST() 的行为取决于数据库实现。在大多数SQL引擎中,NULL值会被排在最后或最前,具体由 ORDER BY 的排序规则决定。例如,若使用 ORDER BY score ASC,NULL值通常被视为最小值,导致其 CUME_DIST() 接近0;若使用 DESC,则接近1。为避免歧义,建议在查询前过滤或填充NULL值。此外,若表中只有一行数据,CUME_DIST() 始终返回1.0,因为该行小于等于自身,比例为1/1。















