








在sql server中,使用stuff函数批量替换文本的核心方法是结合replace函数或字符串操作,通过update语句对表中的列进行更新。具体做法是调用update 表名 set 列名 = stuff(列名, 起始位置, 长度, '新文本'),其中起始位置和长度通常由charindex或patindex动态计算得出,以定位需要替换的子串。若需全局替换所有匹配项,可借助递归cte或循环逐次替换,直到不再找到目标子串为止。此方法适用于已知固定模式或前缀/后缀的替换场景,对于复杂正则需求则建议改用clr或外部脚本。

如何一次性替换某列中特定子串的第一处出现?
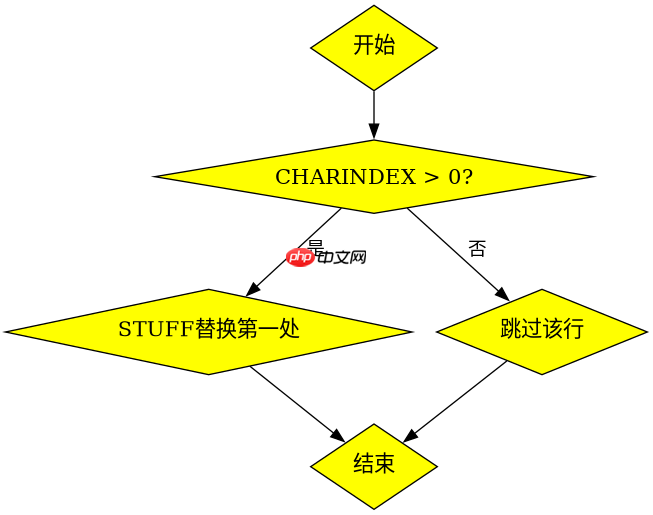
要替换某列中特定子串的第一处出现,可使用STUFF配合CHARINDEX获取子串起始位置,并传入子串长度作为删除长度。例如,将col1中第一个出现的'old'替换为'new',只需计算CHARINDEX('old', col1)得到起始索引,再用LEN('old')确定删除长度,最后用STUFF插入新文本。该操作仅影响每行第一次匹配,后续匹配保持不变。
UPDATE MyTable
SET col1 = STUFF(col1, CHARINDEX('old', col1), LEN('old'), 'new')
WHERE CHARINDEX('old', col1) > 0;
上述代码执行后,MyTable中每行col1字段若包含'old',其首次出现将被替换为'new'。若某行不含'old',因WHERE条件过滤,该行不受影响。注意CHARINDEX返回1-based索引,与STUFF要求一致,无需调整偏移量。
如何实现某列中所有匹配子串的逐个替换?
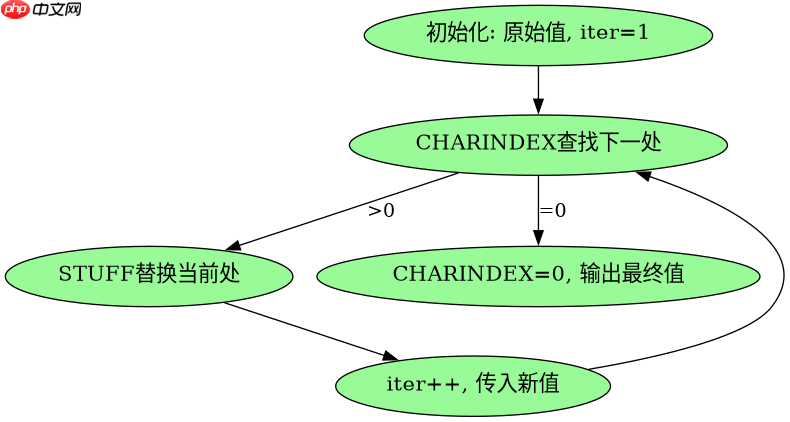
要实现某列中所有匹配子串的逐个替换,需利用递归CTE反复调用STUFF,每次替换一处后重新搜索剩余部分,直至无更多匹配。具体而言,定义一个CTE,初始状态为原始数据,每一步查找当前值中下一个'target'的位置,用STUFF替换它,并将结果传入下一轮迭代,直到CHARINDEX返回0表示无更多匹配。最终选取最后一轮结果即为全量替换后的值。
WITH ReplaceAll AS (
    SELECT id, col1 AS current_val, 1 AS iteration
    FROM MyTable
    UNION ALL
    SELECT r.id,
           STUFF(r.current_val, CHARINDEX('target', r.current_val), LEN('target'), 'replacement'),
           r.iteration + 1
    FROM ReplaceAll r
    WHERE CHARINDEX('target', r.current_val) > 0
)
SELECT id, current_val AS final_col1
FROM (
    SELECT id, current_val, ROW_NUMBER() OVER (PARTITION BY id ORDER BY iteration DESC) AS rn
    FROM ReplaceAll
) sub
WHERE rn = 1;
该查询对MyTable中每行col1字段执行全量替换:将所有'target'实例依次替换为'replacement'。递归过程确保即使一行含多个匹配项也能完整处理。最终输出按id分组取最大迭代轮次的结果,即完全替换后的字符串。若原字符串无匹配项,则直接返回原值,因CTE不会进入递归分支。
当替换目标子串重叠时,STUFF行为如何影响结果?
当替换目标子串存在重叠情况时,STUFF基于单次定位执行替换,不会自动处理重叠区域,可能导致部分匹配被跳过或意外截断。例如,若原字符串为'aaaa',目标为'aa',第一次替换从位置1开始删除两个字符并插入新文本,剩余部分从原位置3继续,但原位置3和4构成的'aa'因已被移动或覆盖而不再匹配。因此,重叠子串无法通过简单STUFF+CHARINDEX链式调用完整替换,需预先拆分或非重叠策略处理。


















